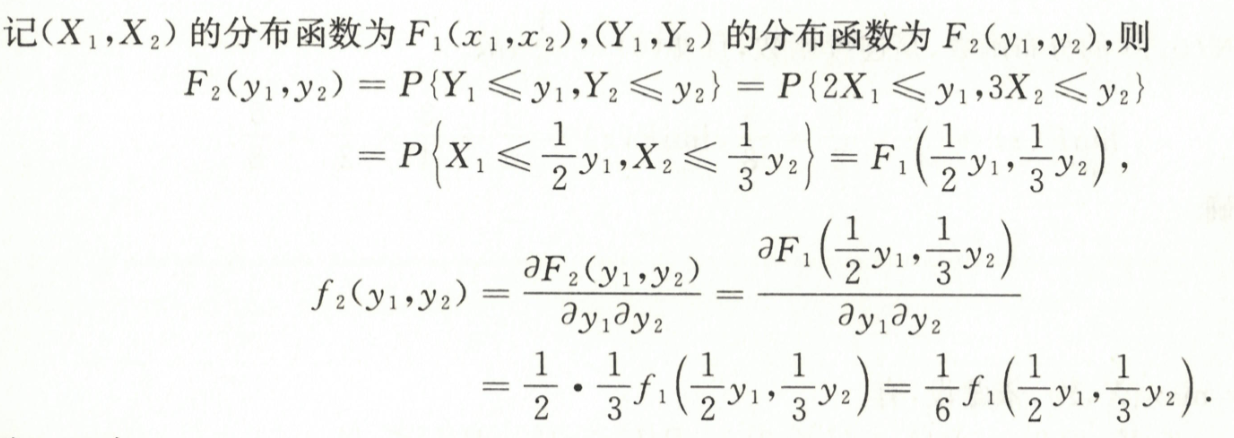LOADING

加载过慢请开启缓存 浏览器默认开启

Coldrain 的 27 考研数一概统强化阶段拾遗

“岂不闻天无绝人之路,只要我想走,路就在脚下。”—— 25 奥本海豚

1. 随机事件及其概率

💡 本章易错题:

  • 【880-16-基础-选择-4、7】
  • 【880-16-综合-填空-1、4、5】
  1. 事件的关系

    • (1)吸收律:若 A⊆BA \subseteq B,则 A∪B=BA\cup B = B,A∩B=AA\cap B = A
    • (2)分配率:
      • A∪(B∩C)=(A∪B)∩(A∪C)A \cup (B \cap C) = (A \cup B) \cap (A \cup C)
      • A∩(B∪C)=(A∩B)∪(A∩C)A \cap (B \cup C) = (A \cap B) \cup (A \cap C)
    • (3)对偶律:
      • A∪B‾=A‾∩B‾\overline{A \cup B} = \overline{A} \cap \overline{B}
      • A∩B‾=A‾∪B‾\overline{A \cap B} = \overline{A} \cup \overline{B}
    • (4)涉及复杂随机事件运算时,考虑使用韦恩图来降低难度
  2. 对立运算

    • P(A‾)=1−P(A)P(\overline{A}) = 1- P(A)
  3. 加法运算(并集)

    • P(A∪B)=P(A+B)=P(A)+P(B)−P(AB)P(A\cup B) = P(A+B) = P(A) + P(B) - P(AB)
    • P(A∪B∪C)=P(A+B+C)=P(A)+P(B)+P(C)−P(AB)−P(AC)−P(BC)+P(ABC)P(A\cup B \cup C) = P(A+B+C) = P(A) + P(B) + P(C)- P(AB) - P(AC) - P(BC) + P(ABC)

💡 加法运算这里 Coldrain 刻意将 “∪\cup” 与 “+” 都写了上去,因为在有些题目中将“并”运算换成加法运算可以快速化简冗长的随机事件表达式

  1. 互不相容(互斥)

    • P(AB)=0P(AB) = 0
    • A∩B=∅A \cap B = \emptyset
    • A‾∪B‾=Ω\overline{A} \cup \overline{B} = \Omega
  2. 减法运算

    • P(A−B)=P(AB‾)=P(A)−P(AB)P(A-B) = P(A\overline{B}) = P(A) - P(AB)
  3. 乘法运算(交集)

    • P(AB)=P(B)P(A∣B)=P(A)P(B∣A)P(AB) = P(B)P(A|B) = P(A) P(B|A)
  4. 条件概率

    • P(B∣A)=P(AB)P(A)P(B|A) = \dfrac{P(AB)}{P(A)}

💡 条件概率常用性质

  • P(B∣A)+P(B‾∣A)=1P(B|A) + P(\overline{B}|A) = 1
  • P(A1∪A2∣B)=P(A1∣B)+P(A2∣B)−P(A1A2∣B)P(A_1 \cup A_2 | B) = P(A_1 | B) + P(A_2 |B) - P(A_1 A_2 |B)
  • P(A1−A2∣B)=P(A1∣B)−P(A1A2∣B)P(A_1 - A_2 | B) = P(A_1 | B) - P(A_1 A_2 |B)
  • AA 与 BB 独立时,有 P(AB∣C)=P(A∣C)P(B∣C)P(AB|C) = P(A|C) P(B|C)
  1. 全概率公式

    • P(B)=∑i=1nP(Ai)P(B∣Ai)P(B) = \sum\limits_{i=1}^{n} P(A_i)P(B|A_i)
  2. 贝叶斯公式

    • P(Ai∣B)=P(AiB)P(B)=P(Ai)P(B∣Ai)P(B)P(A_i|B) = \dfrac{P(A_i B)}{P(B)} = \dfrac{P(A_i)P(B|A_i)}{P(B)}
  3. 事件的独立性

    • (1)两事件独立:P(AB)=P(A)P(B)P(AB) = P(A) P(B)
    • (2)重要结论
      • a. AA 与 BB 独立 ⇔\Leftrightarrow AA 与 B‾\overline{B} 独立 ⇔\Leftrightarrow A‾\overline{A} 与 BB 独立 ⇔\Leftrightarrow A‾\overline{A} 与 B‾\overline{B} 独立
      • b. 概率为 0 和 1 的事件与任何一个事件都相互独立
      • c. 设 B∈(0,1)B \in (0, 1),则 AA 与 BB 独立 ⇔P(A∣B)=P(A∣B‾)=P(A)⇔P(A∣B)+P(A‾∣B‾)=1⇔P(A∣B‾)+P(A‾∣B)=1\Leftrightarrow P(A|B) = P(A |\overline{B}) = P(A) \Leftrightarrow P( A|B) + P(\overline{A} |\overline{B}) = 1 \Leftrightarrow P(A|\overline{B}) + P(\overline{A}|B) = 1
    • (3)A,B,CA, B, C 两两独立:
      • a. P(AB)=P(A)P(B)P(AB) = P(A)P(B)
      • b. P(AC)=P(A)P(C)P(AC) = P(A)P(C)
      • c. P(BC)=P(B)P(C)P(BC) = P(B)P(C)
    • (4)A,B,CA, B, C 相互独立(注意与前者的区分):
      • a. P(AB)=P(A)P(B)P(AB) = P(A)P(B)
      • b. P(AC)=P(A)P(C)P(AC) = P(A)P(C)
      • c. P(BC)=P(B)P(C)P(BC) = P(B)P(C)
      • d. P(ABC)=P(A)P(B)P(C)P(ABC) = P(A) P(B) P(C)
      • (⭐ 易错\textcolor{red}{易错})e. 不重叠分组,各自运算后仍独立;重叠分组,例如 ACAC 与 CC,只有当 P(A)=0P(A) = 0 或 P(C)=0P(C) = 0 或 P(C)=1P(C) = 1 时才会独立,其余情况不独立(P(C)∈(0,1)P(C)\in (0, 1) 时,ACAC 与 BB 相互独立,但 ACAC 与 CC 不相互独立)

💡 两事件独立,进而有:

  • P(A∪B)=P(A)+P(B)−P(A)P(B)=1−P(A‾)P(B‾)P(A\cup B) = P(A) + P(B) - P(A)P(B) = 1 - P(\overline{A})P(\overline{B})
  1. 三大概型(知道分别是什么情况即可,做题时一定要小心,这里经常出现逻辑陷阱)
    • (1)古典概型:列举,有限个样本点
    • (2)几何概型:画图,无限个样本点
    • (3)伯努利概型:每次只有对立的两种结果,独立重复 nn 次试验(伯努利)

⚠️ 本章易错细节

  • (1)P(A)=0P(A) = 0,不代表 AA 为空集!
  • 【逻辑陷阱】(2)已知 10 部手机里有 7 个合格品和 3 个次品,每次取一个测试,测试后不放回,那么事件 “直到将 3 个次品都找到为之,需要测试 7 次” ⇔\Leftrightarrow “第 7 次测试刚好测试出第 3 个次品” ∪\cup “7 次测试出来全是合格品,剩下 3 个全是次品”

2. 一维随机变量及其分布

💡 本章重点习题

  • 【880-17-基础-填空-4、5】
  • 【880-17-基础-解答-7】
  • 【880-17-综合-选择-1、4】
  • 【880-17-综合-填空-4、5、6】

2.1 分布函数

  1. 分布函数的定义:F(x)=P{X≤x},−∞<x<∞F(x) = P\{X \le x\}, -\infty < x< \infty

⚠️ 关于分布函数和概率密度的书写规范(易错)

  • (1)写分布函数 FF 的时候,如果存在多种情况,一定不要漏掉 F(x)=0F(x) = 0 和 F(x)=1F(x) = 1
  • (2)写概率密度函数 ff 的时候,如果有指定区间的话,一定不要忘记把区间外密度 f=0f = 0 也写上去,不然不完整
  1. 分布函数的性质(三个条件都要满足,一般出选择题)
    • (1)单调不减性:F(x)F(x) 是单调非减函数
    • (2)有界性:0≤F(x)≤10\le F(x) \le 1,且 F(+∞)=1F(+\infty) = 1,F(−∞)=0F(-\infty) = 0
    • (3)右连续性:对任意 x0x_0 有 lim⁡x→x0+F(x)=F(x0)\lim\limits_{x\to x_0^+} F(x) = F(x_0) 即 F(x0+0)=F(x0)F(x_0 + 0) = F(x_0)

💡 关于右连续性

  • (1)左闭右开可以保证右连续性
  • (2)若 F(x)F(x) 为分布函数,则 1−F(−x)1 - F(-x) 未必是分布函数,因为右连续倒过来就变成左连续,无法保证右连续
  • (3)P{x1≤X≤x2}=F(x2)−F(x1)P\{x_1 \le X \le x_2\} = F(x_2) - F(x_1),而 P{x1<X<x2}=F(x2−0)−F(x1+0)P\{x_1 < X < x_2\} = F(x_2 - 0) - F(x_1 + 0)(例如 F(x)={0,x<012,0≤x<11−e−x,x≥1F(x) = \begin{cases} 0, & x<0 \\ \dfrac{1}{2}, & 0\le x<1 \\ 1 - e^{-x}, & x\ge 1 \end{cases})
  1. 设 F1(x),F2(x)F_1(x), F_2(x) 均是分布函数,则
    • (1)当 ai≥0,a1+a2=1a_i \ge 0, a_1 + a_2 = 1 时,a1F1(x)+a2F2(x)a_1 F_1(x) + a_2 F_2(x) 仍为某随机变量的分布函数
    • (2)F1(x)F2(x)F_1(x)F_2(x) 仍为分布函数(这也是 X,YX, Y 独立时 max⁡{X,Y}\max\{X, Y\} 的分布函数)
    • (3)1−[1−F1(x)][1−F2(x)]1 - [1 - F_1(x)][1 - F_2(x)] 仍为分布函数(这也是 X,YX, Y 独立时 min⁡{X,Y}\min\{X, Y\} 的分布函数)

✍ 做题小结论:

  • 如果 XX 的分布函数 F(x)F(x) 是连续函数,则有 Y=F(X)~U(0,1)Y=F(X) ~ U(0, 1)【余丙森强化例 2.14】
  • 如果遇到 Y=F(X)Y = F(X) 这种分布套分布的问题,可以尝试将 F(X)F(X) 图像画出来分类讨论,然后 G(y)=P{Y≤y}=P{F(X)≤y}G(y) = P\{Y \le y\} = P\{F(X) \le y\}【880-17-综合-选择-4】
  • P{X=x}=0⇔F(x)−F(x−0)=0⇔F(x)=F(x−0)⇔F(x)P\{X= x\} = 0 \Leftrightarrow F(x) - F(x-0) = 0 \Leftrightarrow F(x) = F(x-0) \Leftrightarrow F(x) 在 xx 处连续

2.2 常见离散型随机变量及其分布律

  1. 0-1 分布

    • X~B(1,p)X~B(1, p)
  2. 二项分布

    • X~B(n,p)X~B(n, p)
    • P{X=k}=Cnkpk(1−p)n−kP\{X = k\} = C_n^k p^k (1-p)^{n-k}
    • 在独立条件下,二项分布具有可加性,即设 X~B(m,p),Y~B(n,p)X~B(m, p), Y~B(n, p),则 X+Y~B(m+n,p)X + Y ~B(m+n, p)(⚠️ 注意:只可加不可减)
    • 若 X1,X2X_1, X_2 相互独立且 X1,X2~B(1,12)⇔X1,X2~(011212)X_1, X_2~B(1, \dfrac{1}{2}) \Leftrightarrow X_1, X_2 ~ \begin{pmatrix} 0 & 1 \\ \dfrac{1}{2} & \dfrac{1}{2} \end{pmatrix},则 X2−X1~(−101141214)X_2 - X_1 ~ \begin{pmatrix} -1 & 0 & 1 \\ \dfrac{1}{4} & \dfrac{1}{2} & \dfrac{1}{4} \end{pmatrix}
  3. 泊松分布

    • X~P(λ)X~P(\lambda),其中 λ≥0\lambda \ge 0
    • P{X=k}=λkk!e−λP\{X = k\} = \dfrac{\lambda^{k}}{k!} e^{-\lambda}

💡 泊松定理(用于近似计算)

设随机变量 X~B(n,p)X~B(n, p),若 lim⁡n→+∞np=λ\lim\limits_{n\to +\infty} np = \lambda

则 lim⁡n→+∞Cnkpk(1−p)n−k=λkk!e−λ=(np)kk!e−(np)\lim\limits_{n\to +\infty} C_n^k p^k (1-p)^{n-k} = \dfrac{\lambda^{k}}{k!} e^{-\lambda} = \dfrac{(np)^{k}}{k!} e^{-(np)}

💡 关于泊松分布的公式

回忆一下,在高数里面我们学过一个泰勒展开式:ex=1+x+x22!+x33!+...=∑k=0∞xkk!e^x = 1+x+\dfrac{x^2}{2!} + \dfrac{x^3}{3!} + ... = \sum\limits_{k=0}^{\infty} \dfrac{x^k}{k!}

我们将其中的 xx 换成 λ\lambda,就有 eλ=∑k=0∞λkk!e^{\lambda} = \sum\limits_{k=0}^{\infty} \dfrac{\lambda^k}{k!}

那么接下来就有 ∑k=0∞λkk!e−λ=e−λ∑k=0∞λkk!=e−λ⋅eλ=1\sum\limits_{k=0}^{\infty} \dfrac{\lambda^k}{k!}e^{-\lambda} = e^{-\lambda} \sum\limits_{k=0}^{\infty} \dfrac{\lambda^k}{k!} = e^{-\lambda} \cdot e^{\lambda} = 1

诶?!所有离散样本点的概率和为 1,这就是泊松分布的分布律了!

上面泊松分布的来历可以记一下,也许有的题目会出喵 🐱

  1. 几何分布

    • P{X=k}=(1−p)k−1pP\{ X = k\} = (1-p)^{k-1} p
    • 几何分布具有无记忆性,即 P{X>m+n∣X>m}=P{X>n}P\{ X > m+n | X > m\} = P\{ X > n\}
  2. 超几何分布

    • P{X=k}=CMkCN−Mn−kCNnP\{ X = k\} = \dfrac{C_M^k C_{N-M}^{n-k}}{C_N^n}

2.3 常见连续型随机变量及其概率密度

  1. 概率密度
    • (1)定义:F(x)=∫−∞xf(t)dtF(x) = \int^{x}_{-\infty} f(t)dt
    • (2)性质(会出选择题)
      • a. f(x)≥0f(x) \ge 0
      • b. ∫∞+∞f(x)dx=1\int^{+\infty}_{\infty} f(x) dx = 1

💡 关于概率密度性质的一道例题:设 f(x)f(x) 为随机变量 XX 的概率密度,则下列选项可以作为某一随机变量的概率密度的是()

  • A. f(1−x)f(1-x)(✅,因为 ∫−∞+∞f(1−x)dx=−∫−∞+∞f(1−x)d(1−x)=∫−∞+∞f(t)dt=1\int^{+\infty}_{-\infty}f(1-x) dx = -\int^{+\infty}_{-\infty}f(1-x) d(1-x) = \int^{+\infty}_{-\infty}f(t) dt = 1)
  • B. f(x2)f(\dfrac{x}{2})(❌,因为 ∫−∞+∞f(x2)dx=2∫−∞+∞f(x2)dx2=2≠1\int^{+\infty}_{-\infty} f(\dfrac{x}{2}) dx = 2\int^{+\infty}_{-\infty} f(\dfrac{x}{2}) d\dfrac{x}{2} = 2 \ne 1)
  • C. f(x2)f(x^2)(❌,积分不为 1)
  • D. f2(x)f^2(x)(❌,积分不为 1)
  1. 均匀分布

    • X~U(a,b)X~U(a, b)
    • 概率密度:f(x)={1b−a,a<x<b0,otherwisef(x) = \begin{cases} \dfrac{1}{b-a}, & a<x<b \\ 0,& otherwise \end{cases}
    • 分布函数:F(X)={0,x<ax−ab−a,a≤x<b1,x≥bF(X) = \begin{cases} 0, & x<a \\ \dfrac{x-a}{b-a}, & a\le x < b \\ 1, & x\ge b \end{cases}
  2. 指数分布

    • (1)X~E(λ)X~E(\lambda),其中 λ≥0\lambda \ge 0
    • (2)概率密度:f(x)={λe−λx,x>00,otherwisef(x) = \begin{cases} \lambda e^{-\lambda x}, & x>0 \\ 0, & otherwise\end{cases}
    • (3)分布函数:F(X)={0,x≤01−e−λx,x>0F(X) = \begin{cases} 0, & x\le 0 \\ 1-e^{-\lambda x}, & x>0\end{cases}
    • (4)指数分布也具有无记忆性
    • (5)指数分布的一种变种:f(x)={λe−λ(x−θ),x≥θ0,x<θf(x) = \begin{cases} \lambda e^{-\lambda(x - \theta)}, & x \ge \theta \\ 0, & x < \theta \end{cases}
    • (6)若 X1~E(λ1),X2~E(λ2)X_1~E(\lambda_1), X_2~E(\lambda_2),则 Y=min⁡X1,X2~E(λ1+λ2)Y = \min{X_1, X_2} ~ E(\lambda_1 + \lambda_2)。该结论证明很简单,相关题目见【880-19-综合-解答-3、4】
  3. 正态分布

    • X~N(μ,σ2)X~N(\mu, \sigma^2)
    • 概率密度:f(x)=12πσe−(x−μ)22σ2,−∞<x<+∞f(x) = \dfrac{1}{\sqrt{2\pi} \sigma} e^{- \frac{(x-\mu)^2}{2\sigma^2}}, -\infty < x < +\infty
    • 分布函数:F(X)=12πσ∫−∞xe−(t−μ)22σ2dtF(X) = \dfrac{1}{\sqrt{2\pi}\sigma} \int^{x}_{-\infty} e^{-\frac{(t-\mu)^2}{2\sigma^2}} dt

💡 正态分布的性质:

  • 当 μ=0,σ2=1\mu =0 , \sigma^2=1 时,X~N(0,1)X~N(0, 1) 称为标准正态分布,密度函数为 φ(x)\varphi(x),分布函数为 Φ(x)\Phi(x)

  • 对任意 X~N(μ,σ2)X~N(\mu, \sigma^2),有 X−μσ~N(0,1)\dfrac{X - \mu}{\sigma}~N(0, 1)

  • Φ(−a)=1−Φ(a)\Phi(-a) = 1 - \Phi(a)

  • aX+b~N(aμ+b,a2σ2)aX+b ~N(a\mu + b, a^2\sigma^2)

  • 设 X~N(μ,σ2)X~N(\mu, \sigma^2),则分布函数 F(x)=P{X≤x}=P{X−μσ≤x−μσ}=Φ(x−μσ)F(x) = P\{X \le x\} = P\{ \dfrac{X-\mu}{\sigma} \le \dfrac{x-\mu}{\sigma}\} = \Phi(\dfrac{x- \mu}{\sigma})

⚠️ 正态分布常考难点

  • 做题的时候,给定类似于 f(x)=Aex(B−x)f(x) = A e^{x(B - x)} 要能看出来是正态分布(Aex(B−x)=AeBx−x2=Ae−(x−B2)2+B24=AeB24e−(x−B2)2A e^{x(B - x)} = A e^{Bx - x^2} = A e^{-(x-\frac{B}{2})^2 + \frac{B^2}{4}} = A e^{\frac{B^2}{4}} e^{-(x-\frac{B}{2})^2})
  • 计算 E(eX)=∫−∞+∞ex12πσe(x−μ)22σ2dxE(e^X) = \int^{+\infty}_{-\infty} e^x \dfrac{1}{\sqrt{2\pi} \sigma} e^{\frac{(x-\mu)^2}{2\sigma^2}} dx,思路是将这个积分里的式子转换成另一个正态分布的的概率密度函数(27 张宇 1000a P70 第 9 题)
  • X~N(μ,σ2)X~N(\mu, \sigma^2),计算 E(∣X∣)E(|X|) 与 D(∣X∣)D(|X|)(用定义算)

2.4 连续型随机变量与概率密度相关问题求解

  1. Y=g(X)Y = g(X)
    • (1)若 XX 的概率密度为 fX(x)f_X(x),则
      • a. YY 为离散型:求 YY 的分布律
      • b. YY 为连续型:先求 YY 的分布函数,再求概率密度
      • c. YY 既不是离散型也不是连续型:只求分布函数
    • (2)YY 为非离散型时分布函数的求解:FY(y)=P{Y≤y}=P{g(X)≤y}=P{φ(y)≤X≤ψ(y)}=∫ψ(y)φ(y)fX(x)dxF_Y(y) = P\{Y\le y\} = P\{g(X) \le y\} = P\{\varphi(y) \le X \le \psi(y)\} = \int^{\varphi(y)}_{\psi(y)} f_X(x) dx(若 YY 为连续型,可进一步求导得到 YY 的概率密度 fY(y)=FY′(y)f_Y(y) = F'_Y(y))
    • (3)计算时的注意事项
      • a. ∫ψ(y)φ(y)fX(x)dx\int^{\varphi(y)}_{\psi(y)} f_X(x) dx 计算过程中,经常需要对 yy 分段讨论(比如 Y=max⁡{1X,X}Y = \max \{\dfrac{1}{X}, X\})

3. 二维随机变量及其分布

⚠️ 本章涉及易错点:分类讨论、区间判定、二重积分,计算时极其容易在取值范围上出错,一定要谨慎分类讨论,可画图辅助判断!

💡 本章重点习题

  • 【880-18-基础-选择-1、3】
  • 【880-18-基础-解答-2、3、5、6、9】
  • 【880-18-综合-选择-2】
  • 【880-18-综合-填空-1】
  • 【880-18-综合-解答-5、7、8】

3.1 二维随机变量及其分布

  1. 二维随机变量 (X,Y)(X, Y) 落在矩形区域 D={(X,Y)∣x1<X≤x2,y1<Y≤y2}D = \{ (X, Y) | x_1 < X \le x_2, y_1 < Y \le y_2\} 上的概率为 P{x1<X≤x2,y1<Y≤y2}=F(x2,y2)−F(x1,y2)−F(x2,y1)+F(x1,y1)P\{x_1 < X \le x_2, y_1 < Y \le y_2\} = F(x_2, y_2) - F(x_1, y_2) - F(x_2, y_1) + F(x_1, y_1)

  2. 二维随机变量的边缘分布

    • (1)FX(x)=F(X,+∞)=lim⁡y→+∞F(X,Y)F_X(x) = F(X, +\infty) = \lim\limits_{y\to +\infty}F(X, Y)
    • (2)FY(y)=F(+∞,Y)=lim⁡x→+∞F(X,Y)F_Y(y) = F(+\infty, Y) = \lim\limits_{x\to +\infty}F(X, Y)

⚠️ 易错点:边缘分布不能唯一确定联合分布【880-18-基础-选择-3】

  1. 卷积公式(应对特殊分布):
    • (1)Z=X+YZ = X + Y:fZ(z)=∫−∞+∞f(x,z−x)dx=∫−∞+∞f(z−y,y)dyf_Z(z) = \int^{+\infty}_{-\infty} f(x, z-x) dx = \int^{+\infty}_{-\infty} f(z-y, y) dy
    • (2)Z=X−YZ = X - Y:fZ(z)=∫−∞+∞f(x,x−z)dx=∫−∞+∞f(z+y,y)dyf_Z(z) = \int^{+\infty}_{-\infty} f(x, x-z) dx = \int^{+\infty}_{-\infty} f(z+y, y) dy

💡 当 XX 与 YY 相互独立时,有:

  • (1)Z=X+YZ = X + Y:fZ(z)=∫−∞+∞fX(x)fY(z−x)dx=∫−∞+∞fX(z−y)fY(y)dyf_Z(z) = \int^{+\infty}_{-\infty} f_X(x)f_Y(z-x) dx = \int^{+\infty}_{-\infty} f_X(z-y)f_Y(y) dy
  • (2)Z=X−YZ = X - Y:fZ(z)=∫−∞+∞fX(x)fY(x−z)dx=∫−∞+∞fX(z+y)fY(y)dyf_Z(z) = \int^{+\infty}_{-\infty} f_X(x)f_Y(x-z) dx = \int^{+\infty}_{-\infty} f_X(z+y)f_Y(y) dy
  1. 二维连续随机变量:F(X,Y)=∫−∞x∫−∞yf(x,y)dxdyF(X, Y) = \int^{x}_{-\infty} \int^{y}_{-\infty}f(x, y) dxdy

💡 做题的时候经常使用:F(X,Y)=∫−∞x∫−∞yf(u,v)dudvF(X, Y) = \int^{x}_{-\infty} \int^{y}_{-\infty}f(u, v) dudv,这样方便区分 x,yx, y

💡 设二维随机变量 (X1,X2)(X_1, X_2) 的概率密度为 f1(x1,x2),Y1=2X1,Y2=3X2f_1(x_1, x_2), Y_1 = 2X_1, Y_2 = 3X_2,则 (Y1,Y2)(Y_1, Y_2) 的概率密度 f2(y1,y2)f_2(y_1, y_2) 计算方式:

  • pos_1
  1. 二维连续随机变量的边缘概率密度:
    • (1)fX(x)=∫−∞+∞f(x,y)dyf_X(x) = \int^{+\infty}_{-\infty} f(x, y)dy
    • (2)fY(y)=∫−∞+∞f(x,y)dxf_Y(y) = \int^{+\infty}_{-\infty} f(x, y)dx

⚠️ 二维 离散\textcolor{red}{离散} 随机变量 (U,V)(U, V) 的联合概率分布最好写成表格的形式

💡 假设 F(X)F(X) 式子比较复杂,要计算 P{F(X)≤u}P\{F(X) \le u\} 时,可以这样计算:

  • P{F(X)≤u}=P{X≤F−1(u)}=∫−∞F−1(u)f(x)dx=∫−∞F−1(u)dF(x)=u−F(−∞)P\{F(X) \le u\} = P\{X \le F^{-1}(u)\} = \int^{F^{-1}(u)}_{-\infty} f(x) dx = \int^{F^{-1}(u)}_{-\infty} dF(x) = u - F(-\infty)(神乎其技)

3.2 二维随机变量的独立性

  1. 二维随机变量独立,则有 F(x,y)=FX(x)FY(y)F(x, y) =F_X(x) F_Y(y)

  2. 二维离散型随机变量独立的充要条件:P{X=xi,Y=yj}=P{X=xi}P{Y=yj}P\{X=x_i, Y=y_j\} = P\{X=x_i\}P\{Y=y_j\}

  3. 二维连续型随机变量独立的充要条件:f(x,y)=fX(x)fY(y)f(x, y) = f_X(x) f_Y(y)

  4. 若 XX 与 YY 相互独立,则其函数 f(X)f(X) 与 g(Y)g(Y) 也相互独立

  5. 若 XX 与 YY 相互独立,则

    • (1)若 X~P(λ1)X~P(\lambda_1),Y~P(λ2)Y~P(\lambda_2),则 X+Y~P(λ1+λ2)X+Y ~P(\lambda_1+\lambda_2)
    • (2)若 X~B(m,p)X~B(m, p),Y~B(n,p)Y~B(n, p),则 X+Y~B(m+n,p)X+Y ~B(m+n, p)
    • (3)若 X~E(λ1)X~E(\lambda_1),Y~E(λ2)Y~E(\lambda_2),则 min⁡{X,Y}~E(λ1+λ2)\min\{X, Y\} ~E(\lambda_1 + \lambda_2)

⚠️ 可加性结论考试时最好先证明一遍!

3.3 二维均匀分布

  1. 定义:设 GG 为平面上面积为 AA 的有界区域,(X,Y)(X, Y) 服从区域 GG 上的均匀分布,则有 f(x,y)={1A,(x,y)∈G0,otherwisef(x, y) = \begin{cases} \dfrac{1}{A}, & (x, y) \in G \\ 0, & otherwise \end{cases}

  2. 性质:

    • (1)若 (X,Y)(X, Y) 服从矩形区域 G={(x,y)∣a<x<b,c<y<d}G = \{(x, y)| a<x<b, c<y<d\} 上的均匀分布,则 X~U(a,b)X~U(a, b),Y~U(c,d)Y~U(c, d),且 XX 与 YY 相互独立,两个条件分布也是均匀分布
    • (2)若 (X,Y)(X, Y) 服从圆形区域 G={(x,y)∣x2+y2≤r2}G = \{(x, y)|x^2 + y^2 \le r^2\} 上的均匀分布,则两个边缘分布都不是均匀分布,且 XX 与 YY 不独立,但其两个条件分布都是均匀分布

3.4 二维正态分布

  1. 定义:
    • (X,Y)~N(μ1,μ2,σ12,σ22,ρ)(X, Y)~N(\mu_1, \mu_2, \sigma_1^2, \sigma_2^2, \rho)
    • f(x,y)=12πσ1σ21−ρ2exp⁡{−1(1−ρ2)[(x−μ1)22σ12−ρ(x−μ1)(y−μ2)σ1σ2+(y−μ2)2]2σ22]}f(x ,y) = \dfrac{1}{2\pi \sigma_1 \sigma_2 \sqrt{1-\rho^2}} \exp \{-\dfrac{1}{(1-\rho^2)}[\dfrac{(x-\mu_1)^2}{2\sigma_1^2} - \rho \dfrac{(x-\mu_1)(y-\mu_2)}{\sigma_1 \sigma_2} + \dfrac{(y-\mu_2)^2]}{2\sigma_2^2}] \}

💡 公式里的 ρ\rho 是 XX 与 YY 的相关系数(Pearson 相关系数),在后面的章节里面会学到,计算方式为:ρ=Cov(X,Y)σ1σ2=E(XY)−E(X)E(Y)σ1σ2 \rho = \dfrac{Cov(X, Y)}{\sigma_1 \sigma_2} = \dfrac{E(XY) - E(X)E(Y)}{\sigma_1 \sigma_2}

  1. 性质:
    • (1)两个边缘分布都是正态分布,即 X~N(μ1,σ12)X~N(\mu_1, \sigma_1^2)、Y~N(μ2,σ22)Y~N(\mu_2, \sigma_2^2)
    • (2)XX 与 YY 相互独立 ⇔ρXY=ρ=0⇔X\Leftrightarrow \rho_{XY} = \rho = 0 \Leftrightarrow X 与 YY 不相关
    • (3)XX 与 YY 的非零线性组合 (aX+bY,cX+dY)(aX + bY, cX + dY) 也遵从二维正态分布
    • (4)XX 与 YY 的线性组合 aX+bYaX + bY 仍为正态分布,即 aX+bY~N(aμ1+bμ2,a2σ12+b2σ22+2abρσ1σ2)aX + bY ~N(a\mu_1 + b\mu_2, a^2\sigma_1^2 + b^2\sigma_2^2 + 2ab\rho\sigma_1\sigma_2)
    • (5)令 {U=a1X+b1YV=a2X+b2Y\begin{cases} U = a_1 X + b_1 Y \\ V = a_2 X + b_2 Y\end{cases},当 ∣a1b1a2b2∣≠0\begin{vmatrix} a_1 & b_1 \\ a_2 & b_2 \end{vmatrix} \ne 0 时,(U,V)(U, V) 服从二维正态分布

3.5 连续型随机变量 (X, Y) 的分布函数 F(x, y)

  1. F(X,Y)F(X, Y) 求解方法:设 F(x,y)=∫−∞x∫−∞yf(u,v)dudvF(x, y) = \int^{x}_{-\infty} \int^{y}_{-\infty} f(u, v) dudv,然后分类讨论,画图求解

  2. Z=f(X,Y)Z = f(X, Y) 时 FZ(z)F_Z(z) 的求解

    • (1)根据题目条件得到 f(x,y)f(x, y)
    • (2)在 xOyxOy 平面上画出 f(x,y)f(x, y) 的区域 DD
    • (3)在 xOyxOy 平面上画出 y=g(x,z)y = g(x, z) 曲线 ss
    • (4)根据区域 DD 和 ss 画出积分区域
    • (5)在区域 DD 上二重积分计算 FZ(z)F_Z(z)

4. 数字特征

4.1 随机变量的数学期望和方差

  1. 离散型随机变量的数学期望:E(X)=∑k=1∞xkpkE(X) = \sum\limits_{k=1}^{\infty} x_k p_k

  2. 连续型随机变量的数学期望:E(X)=∫−∞+∞xf(x)dxE(X) = \int^{+\infty}_{-\infty} xf(x)dx

  3. 一维随机变量函数的数学期望:

    • 设 Y=g(X)Y = g(X)
    • (1)离散型:E(Y)=E(g(X))=∑k=1∞g(xk)pkE(Y) = E(g(X)) = \sum\limits_{k=1}^{\infty} g(x_k) p_k
    • (2)连续型:E(Y)=E(g(X))=∫−∞+∞g(x)f(x)dxE(Y) = E(g(X)) = \int^{+\infty}_{-\infty} g(x)f(x)dx
  4. 二维随机变量函数的数学期望:

    • 设 Z=g(X,Y)Z = g(X, Y)
    • (1)离散型:E(Z)=E(g(X,Y))=∑i=1+∞∑j=1+∞g(xi,yj)pijE(Z) = E(g(X, Y)) = \sum\limits_{i=1}^{+\infty} \sum\limits_{j=1}^{+\infty} g(x_i, y_j) p_{ij}
    • (2)连续型:E(Z)=E(g(X,Y))=∫−∞+∞∫−∞+∞g(x,y)f(x,y)dxdyE(Z) = E(g(X, Y)) = \int^{+\infty}_{-\infty} \int^{+\infty}_{-\infty} g(x, y) f(x, y) dx dy
  5. 数学期望的性质:

    • (1)E(c)=cE(c) = c
    • (2)E(cX)=cE(X)E(cX) = cE(X)
    • (3)E(aX+bY)=aE(X)+bE(Y)E(aX + bY) = aE(X) + bE(Y)
    • (4)若 XX 与 YY 相互独立,则 E(XY)=E(X)E(Y)E(XY) = E(X) E(Y)
  6. 方差的计算:D(X)=E[X−E(X)]2=E(X2)−[E(X)]2D(X) = E[X - E(X)]^2 = E(X^2) - [E(X)]^2

  7. 方差的性质:

    • (1)D(c)=0D(c) = 0
    • (2)D(cX)=c2D(X)D(cX) = c^2 D(X),D(aX+b)=a2D(X)D(aX + b) = a^2 D(X)
    • (3)D(X±Y)=D(X)+D(Y)±2Cov(X,Y)D(X \pm Y) = D(X) + D(Y) \pm 2Cov(X, Y)
    • (4)D(X±Y±Z)=D(X)+D(Y)+D(Z)±2Cov(X,Y)±2Cov(X,Z)±2Cov(Y,Z)D(X \pm Y \pm Z) = D(X) + D(Y) + D(Z) \pm 2Cov(X, Y) \pm 2Cov(X, Z) \pm 2Cov(Y, Z)
    • (5)若 XX 与 YY 是相互独立的随机变量 ⇒D(X±Y)=D(X)+D(Y)\Rightarrow D(X\pm Y) = D(X) + D(Y)
    • (6)D(X±Y)=D(X)+D(Y)⇔XD(X\pm Y) = D(X) + D(Y) \Leftrightarrow X 与 YY 不相关
    • (7)XX 与 YY 相互独立,且 E(X)=E(Y)=0⇒D(XY)=D(X)D(Y)E(X) = E(Y) = 0 \Rightarrow D(XY) = D(X) D(Y)
  8. 常见随机变量分布的数学期望与方差

分布名称符号分布列或概率密度数学期望方差
0-1 分布B(1,p)B(1, p)P{X=k}=pk(1−p)1−kP\{X=k\}=p^k(1-p)^{1-k}ppp(1−p)p(1-p)
二项分布B(n,p)B(n, p)P{X=k}=Cnkpk(1−p)1−kP\{X=k\}=C_n^kp^k(1-p)^{1-k}npnpnp(1−p)np(1-p)
泊松分布P(λ)P(\lambda)P{X=k}=λkk!e−λP\{X=k\}=\dfrac{\lambda^k}{k!} e^{-\lambda}λ\lambdaλ\lambda
几何分布G(p)G(p)P{X=k}=(1−p)k−1pP\{X=k\}=(1-p)^{k-1}p1p\dfrac{1}{p}1−pp2\dfrac{1-p}{p^2}
超几何分布H(N,M,n)H(N, M, n)待续nMN\dfrac{nM}{N}nMN(1−MN)(N−nN−1)\dfrac{nM}{N}(1-\dfrac{M}{N})(\dfrac{N-n}{N-1})
均匀分布U(a,b)U(a, b)f(x)=1b−af(x) = \dfrac{1}{b-a}a+b2\dfrac{a+b}{2}(b−a)212\dfrac{(b-a)^2}{12}
指数分布E(λ)E(\lambda)f(x)=λe−λf(x) = \lambda e^{-\lambda}1λ\dfrac{1}{\lambda}1λ2\dfrac{1}{\lambda^2}
正态分布N(μ,σ2)N(\mu, \sigma^2)f(x)=12πσe−(x−μ)22σ2f(x) = \dfrac{1}{\sqrt{2\pi} \sigma} e^{-\frac{(x-\mu)^2}{2\sigma^2}}μ\muσ2\sigma^2
卡方分布χ2(n)\chi^2(n)待续nn2n2n
  1. max⁡{...}\max\{...\} 与 min⁡{...}\min\{...\}
    • (1)U=max⁡{X,Y}=X+Y+∣X−Y∣2U = \max\{X, Y\} = \dfrac{X + Y + | X - Y |}{2}
    • (2)V=min⁡{X,Y}=X+Y−∣X−Y∣2V = \min\{X, Y\} = \dfrac{X + Y - |X - Y|}{2}
    • 由上面两个式子,有 U+V=X+YU + V = X + Y,U−V=∣X−Y∣U - V = |X - Y|、UV=XYUV = XY
    • 进而,E(U+V)=E(X+Y)E(U+V) = E(X+Y),E(U−V)=E(∣X−Y∣)E(U-V) = E(|X-Y|),E(UV)=E(XY)E(UV) = E(XY)
    • (3)F(max⁡{X1,X2,⋯ ,Xn})=F(X1)F(X2)⋯F(Xn)F(\max\{X_1, X_2, \cdots, X_n\}) = F(X_1)F(X_2)\cdots F(X_n)。若 X1,X2,⋯ ,XnX_1, X_2, \cdots, X_n 独立同分布,则有 F(max⁡{X1,X2,⋯ ,Xn})=F(X)n⇒f(max⁡{X1,X2,⋯ ,Xn})=nF(X)n−1⋅f(x)F(\max\{X_1, X_2, \cdots, X_n\}) = F(X)^{n} \Rightarrow f(\max\{X_1, X_2, \cdots, X_n\}) = n F(X)^{n-1} \cdot f(x)【880-19-综合-解答-1】
    • (4)F(min⁡{X1,X2,⋯ ,Xn})=1−[1−F(X1)][1−F(X2)]⋯[1−F(Xn)]F(\min\{X_1, X_2, \cdots, X_n\}) = 1 - [1 - F(X_1)][1 - F(X_2)] \cdots [1 - F(X_n)]。若 X1,X2,⋯ ,XnX_1, X_2, \cdots, X_n 独立同分布,则有 F(min⁡{X1,X2,⋯ ,Xn})=1−[1−F(X)]n⇒f(min⁡{X1,X2,⋯ ,Xn})=n[1−F(X)]n−1⋅f(x)F(\min\{X_1, X_2, \cdots, X_n\}) = 1 - [1 - F(X)]^{n} \Rightarrow f(\min\{X_1, X_2, \cdots, X_n\}) = n [1 - F(X)]^{n-1} \cdot f(x)

4.2 协方差与相关系数

  1. 协方差的计算:Cov(X,Y)=E{[X−E(X)][Y−E(Y)]}=E(XY)−E(X)E(Y)Cov(X, Y) = E\{[X - E(X)][Y - E(Y)]\} = E(XY) - E(X)E(Y)

  2. 协方差的性质

    • (1)Cov(X,Y)=Cov(Y,X)Cov(X, Y) = Cov(Y, X)
    • (2)Cov(X,X)=D(X)Cov(X, X) = D(X)
    • (3)Cov(X,c)=0Cov(X, c) = 0
    • (4)Cov(aX,bY)=abCov(X,Y)Cov(aX, bY) = abCov(X, Y)
    • (5)Cov(X1+X2,Y)=Cov(X1,Y)+Cov(X2,Y)Cov(X_1+X_2, Y) = Cov(X_1, Y) + Cov(X_2, Y)
    • (6)如果 XX 与 YY 相互独立 ⇒\Rightarrow XX 与 YY 不相关 ⇔\Leftrightarrow Cov(X,Y)=0Cov(X, Y) = 0
  3. 相关系数 ρXY=Cov(X,Y)D(X)D(Y)\rho_{XY} = \dfrac{Cov(X, Y)}{\sqrt{D(X)} \sqrt{D(Y)}}

  4. 相关系数的性质:

    • (1)∣ρXY∣=1|\rho_{XY}| = 1 的充要条件是:存在常数 a,b(a≠0)a, b(a\neq 0) 使 P{Y=aX+b}=1P\{Y = aX + b\} = 1。且 a>0a>0 时 ρXY=1\rho_{XY} = 1,a<0a<0 时 ρXY=−1\rho_{XY} = -1
  5. 随机变量不相关:ρXY=0\rho_{XY} = 0(或 Cov(X,Y)=0Cov(X, Y) = 0),则 XX 与 YY 不相关

  6. 不相关与独立

    • (1)用韦恩图来表示的话,独立 是被包含在 不相关 里的,即独立一定不相关,但不相关不代表独立(逆否命题:若 XX 与 YY 相关,则 X,YX, Y 不独立)
    • (2)⭐ 当 XX 和 YY 的联合分布为二维正态分布时,独立等价于相关

4.3 随机变量的矩

  1. kk 阶原点矩:E(Xk)E(X^k)(1 阶原点矩就是期望)
  2. kk 阶中心矩:E{[X−E(X)]k}E\{[X - E(X)]^k\}(2 阶中心矩就是方差)
  3. k+lk+l 阶混合原点矩:E(XkYl)E(X^k Y^l)
  4. k+lk+l 阶混合中心矩:E{[X−E(X)]k[Y−E(Y)]l}E\{[X - E(X)]^k [Y - E(Y)]^l\}(1+1 阶混合中心矩就是协方差)

5. 大数定律和中心极限定理

5.1 大数定律

  1. 切比雪夫不等式:设随机变量 XX 的数学期望 E(X)E(X) 和方差 D(X)D(X) 均存在,则对任意 ϵ>0\epsilon >0 ,有
    • P{∣X−E(X)∣≥ϵ}≤D(X)ϵ2P\{|X - E(X)| \ge \epsilon\} \le \dfrac{D(X)}{\epsilon^2}
    • 或 P{∣X−E(X)∣<ϵ}>1−D(X)ϵ2P\{|X - E(X)| < \epsilon\} > 1 - \dfrac{D(X)}{\epsilon^2}

💡 Coldrain 是这样记的:≥ϵ≤\ge \epsilon \le

  1. 切比雪夫大数定律:设随机变量 X1,X2,...,XnX_1, X_2, ..., X_n 相互独立,且数学期望和方差都存在,且存在常数 cc,使 D(Xi)≤c,i=1,2,...D(X_i)\le c, i=1, 2, ...,则对任意正数 ϵ\epsilon,有
    • lim⁡n→∞P{∣1n∑k=1nXk−1n∑k=1nE(Xk)∣<ϵ}=1\lim\limits_{n\to \infty}P\{|\dfrac{1}{n} \sum\limits_{k=1}^{n} X_k - \dfrac{1}{n} \sum\limits_{k=1}^{n} E(X_k)|<\epsilon \} = 1
    • 该定理表明:当 nn 很大时,1n∑k=1nXk⟶P1n∑k=1nE(Xk)\dfrac{1}{n}\sum\limits_{k=1}^{n} X_k \overset{P}{\longrightarrow} \dfrac{1}{n}\sum\limits_{k=1}^{n}E(X_k)

下面两个大数定律都是切比雪夫大数定律的特殊形式

  1. 伯努利大数定律:设 X1,X2,...,XnX_1, X_2, ..., X_n 独立且同分布于 0-1 分布 B(1,p)B(1, p),则对任意正数 ϵ\epsilon,有
    • lim⁡n→∞P{∣1n∑i=1nXi−p∣<ϵ}=1\lim\limits_{n\to \infty} P\{|\dfrac{1}{n}\sum\limits_{i=1}^{n}X_i - p|<\epsilon\} = 1

💡 伯努利大数定律的等价形式

设 nn 次独立重复事件 A 发生的次数为 nA~B(n,p)n_A ~B(n, p),则对任意正数 ϵ\epsilon 有:

  • lim⁡n→∞P{∣nAn−p∣<ϵ}=1\lim\limits_{n\to \infty} P\{|\dfrac{n_A}{n} - p|<\epsilon\} = 1
  1. 辛钦大数定律:设 X1,X2,...,XnX_1, X_2, ..., X_n 独立且同分布,且有相同数学期望 E(Xi)=μE(X_i) = \mu,则对任意正数 ϵ\epsilon,有
    • lim⁡n→∞P{∣1n∑i=1nXi−μ∣<ϵ}=1\lim\limits_{n\to \infty} P\{|\dfrac{1}{n}\sum\limits_{i=1}^{n}X_i - \mu|<\epsilon\} = 1

5.2 中心极限定理

  1. 列维-林德伯格中心极限定理(条件:独立、同分布、期望方差均存在):设 X1,X2,...,XnX_1, X_2, ..., X_n 独立且同分布,且有相同数学期望 E(Xi)=μE(X_i) = \mu 和方差 D(Xi)=σ2D(X_i) = \sigma^2,则对任意实数 xx,有
    • lim⁡n→∞P{1n∑i=1nXi−μσ/n≤x}=∫−∞x12πe−t22dt=Φ(x)\lim\limits_{n\to\infty} P\{\dfrac{\frac{1}{n}\sum_{i=1}^{n}X_i - \mu}{\sigma / \sqrt{n}} \le x\} = \int^{x}_{-\infty} \dfrac{1}{\sqrt{2\pi}} e^{-\frac{t^2}{2}} dt = \Phi(x)
    • 定理表明:当 nn 充分大时,X‾=1n∑i=1nXi~近似N(μ,σ2n)\overline{X} = \dfrac{1}{n}\sum\limits_{i=1}^{n}X_i\overset{近似}{~}N(\mu, \dfrac{\sigma^2}{n}),其标准化 X‾−μσ/n\dfrac{\overline{X} - \mu}{\sigma / \sqrt{n}} 近似服从标准正态分布 N(0,1)N(0, 1)

⚠️ 易错题:设随机变量 X1,X2,⋯ ,XnX_1, X_2, \cdots, X_n 相互独立,记 Yn=X1+X2+⋯+XnY_n = X_1 + X_2 + \cdots + X_n,根据列维-林德伯格中心极限定理,YnY_n 近似服从正态分布(nn 充分大),则只要 X1,X2,⋯ ,XnX_1, X_2, \cdots, X_n( )

  • A. 服从同一离散型分布(❌,期望或方差不一定存在,例如 P(X=k)=6π2k2,(k=1,2,3,...)P(X = k) = \dfrac{6}{\pi^2 k^2}, (k=1, 2, 3, ...),其所有情况之和为 1 是合法的,但 E(X)=6π2∑k=1∞1k→∞E(X) = \dfrac{6}{\pi^2} \sum\limits_{k=1}^{\infty} \dfrac{1}{k} \rightarrow \infty 不存在)
  • B. 服从同一连续型分布(❌,期望或方差不一定存在,和上面 AA 一样,同样可举出反例 f(x)=1π(1+x2)f(x) = \dfrac{1}{\pi(1 + x^2)})
  • C. 服从同一指数分布(✅ 指数分布的期望与方差均存在)
  • D. 具有相同的期望和方差(❌,有相同的期望与方差未必有相同的分布)
  1. 棣莫佛-拉普拉斯中心极限定理(二项分布的极限是正态):设随机变量 Yn~B(n,p)Y_n ~B(n, p),则对任意实数 xx,有
    • lim⁡n→∞P{Yn−npnp(1−p)≤x}=∫−∞x12πe−t22dt=Φ(x)\lim\limits_{n\to\infty} P\{\dfrac{Y_n - np}{\sqrt{np(1-p)}} \le x\} = \int^{x}_{-\infty} \dfrac{1}{\sqrt{2\pi}} e^{-\frac{t^2}{2}} dt = \Phi(x)
    • 定理表明:当 nn 充分大时,Yn~近似N(np,np(1−p))Y_n\overset{近似}{~}N(np, np(1-p)),其标准化随机变量 Yn−npnp(1−p)\dfrac{Y_n - np}{\sqrt{np(1-p)}} 近似服从标准正态分布 N(0,1)N(0, 1),即正态分布是二项分布的极限分布

6. 数理统计的基本概念

6.1 总体与样本

  1. 总体是指与所研究的问题有关的个体的全体所构成的集合,在数理统计中,总体就是一个服从某概率分布的随机变量 XX,其概率分布称为总体分布,其数字特征称为总体数字特征

  2. 样本的性质:

    • 独立性:X1,X2,...,XnX_1, X_2, ..., X_n 相互独立
    • 代表性:XiX_i 与 XX 同分布
    • 无变量重叠的连续函数 U(X1,X2,...,Xk)U(X_1, X_2, ..., X_k) 和 V(Xk+1,Xk+2,...,Xn)V(X_{k+1}, X_{k+2}, ..., X_{n}) 相互独立

6.2 统计量

  1. 统计量:样本 X1,X2,...,XnX_1, X_2, ..., X_n 的不含总体任何未知参数的函数 g(X1,X2,...,Xn)g(X_1, X_2, ..., X_n)

  2. 常见统计量

    • (1)样本均值:X‾=1n∑i=1nXi\overline{X} = \dfrac{1}{n} \sum\limits_{i=1}^{n} X_i
    • (2)样本方差:S2=1n−1∑i=1n(Xi−X‾)2=1n−1(∑i=1nXi2−nX‾)S^2 = \dfrac{1}{n-1}\sum\limits^{n}_{i=1}(X_i - \overline{X})^2 = \dfrac{1}{n-1} (\sum\limits_{i=1}^{n} X_i^2 - n \overline{X})
    • (3)样本标准差 S=S2S = \sqrt{S^2}
    • (4)样本 kk 阶原点矩 Ak=1n∑i=1nXikA_k = \dfrac{1}{n} \sum\limits_{i=1}^{n} X_i^k
    • (5)样本 kk 阶中心矩 Bk=1n∑i=1n(Xi−X‾)kB_k = \dfrac{1}{n} \sum\limits_{i=1}^{n} (X_i - \overline{X})^k
    • (6)顺序统计量:X1∗=min⁡{X1,X2,...,Xn}X_1^* = \min\{X_1, X_2, ..., X_n\},X2∗=max⁡{X1,X2,...,Xn}X_2^* = \max\{X_1, X_2, ..., X_n\},其分布函数分别为
      • Fmin⁡(x)=P{min⁡(X1,X2,...,Xn)≤x}=1−[1−F(x)]nF_{\min}(x) = P\{\min(X_1, X_2, ..., X_n) \le x\} = 1 - [1-F(x)]^n
      • Fmax⁡(x)=P{max⁡(X1,X2,...,Xn)≤x}=[F(x)]nF_{\max}(x) = P\{\max(X_1, X_2, ..., X_n) \le x\} = [F(x)]^n

重要结论

  • E(X‾)=E(X)=μE(\overline{X}) = E(X) = \mu
  • D(X‾)=D(X)n=σ2nD(\overline{X}) = \dfrac{D(X)}{n} = \dfrac{\sigma^2}{n}
  • E(S2)=D(X)=σ2E(S^2) = D(X) = \sigma^2

6.3 卡方分布

  1. 定义:设(X1,X2,...,Xn)(X_1, X_2, ..., X_n)为来自总体 X~N(0,1)X~N(0, 1)的一个简单随机样本,那么统计量 χ2=X12+X22+...+Xn2\chi^2 = X_1^2 + X_2^2 + ... + X_n^2 为服从自由度为 nn 的 χ2\chi^2 分布,记作 χ2~χ2(n)\chi^2~\chi^2(n)

  2. χ2\chi^2 分布的性质:

    • (1)设 X~N(0,1)X~N(0, 1),则 X2~χ2(1)X^2 ~ \chi^2(1),E(X2)=1E(X^2) = 1,D(X2)=2D(X^2) = 2
    • (2)设 χ2~χ2(n)\chi^2~\chi^2(n),则 E(χ2)=nE(\chi^2) = n,D(χ2)=2nD(\chi^2) = 2n
    • (3)设 χi2~χ2(ni)\chi_i^2~\chi^2(n_i),且 χ12\chi_1^2,χ22\chi_2^2 相互独立,则 χ12+χ22~χ2(n1+n2)\chi_1^2 + \chi_2^2 ~ \chi^2(n_1 + n_2)

6.4 t 分布(双边)

  1. 定义:设 X~N(0,1)X~N(0, 1),Y~χ2(n)Y~\chi^2(n),且 XX 与 YY 相互独立,则称 T=XY/nT = \dfrac{X}{\sqrt{Y/n}} 为服从自由度为 nn 的 tt 分布,记作 T~t(n)T~t(n)

  2. 性质:

    • (1)tt 分布概率密度 f(x)f(x) 为偶函数,函数图像关于 yy 轴对称,则 t1−α(n)=−tα(n)t_{1-\alpha}(n) = -t_{\alpha}(n)
    • (2)当 n→∞n\to \infty 时,tt 分布 T~近似N(0,1)T\overset{近似}{~}N(0, 1)
    • (3)T2~F(1,n)T^2 ~ F(1, n)

⚠️ 易错题:余丙森强化例 6.5、6.7

6.5 F 分布

  1. 定义:设 X~χ2(n1)X~\chi^2(n_1),Y~χ2(n2)Y~\chi^2(n_2),且 XX 与 YY 相互独立,则称 F=X/n1Y/n2F = \dfrac{X/n_1}{Y/n_2} 为服从第一自由度为 n1n_1,第二自由度为 n2n_2 的 FF 分布,记作 F~F(n1,n2)F~F(n_1, n_2)

  2. F 分布的性质

    • (1)若 F~F(n1,n2)F~F(n_1, n_2),则 1F~F(n2,n1)\dfrac{1}{F} ~ F(n_2, n_1)
    • (2)若 T~t(n)T~t(n),则 T2=X2Y/n~F(1,n)T^2 = \dfrac{X^2}{Y/n} ~ F(1, n)
    • (3)F1−α(n1,n2)=1Fα(n2,n1)F_{1-\alpha}(n_1, n_2) = \dfrac{1}{F_{\alpha}(n_2, n_1)}

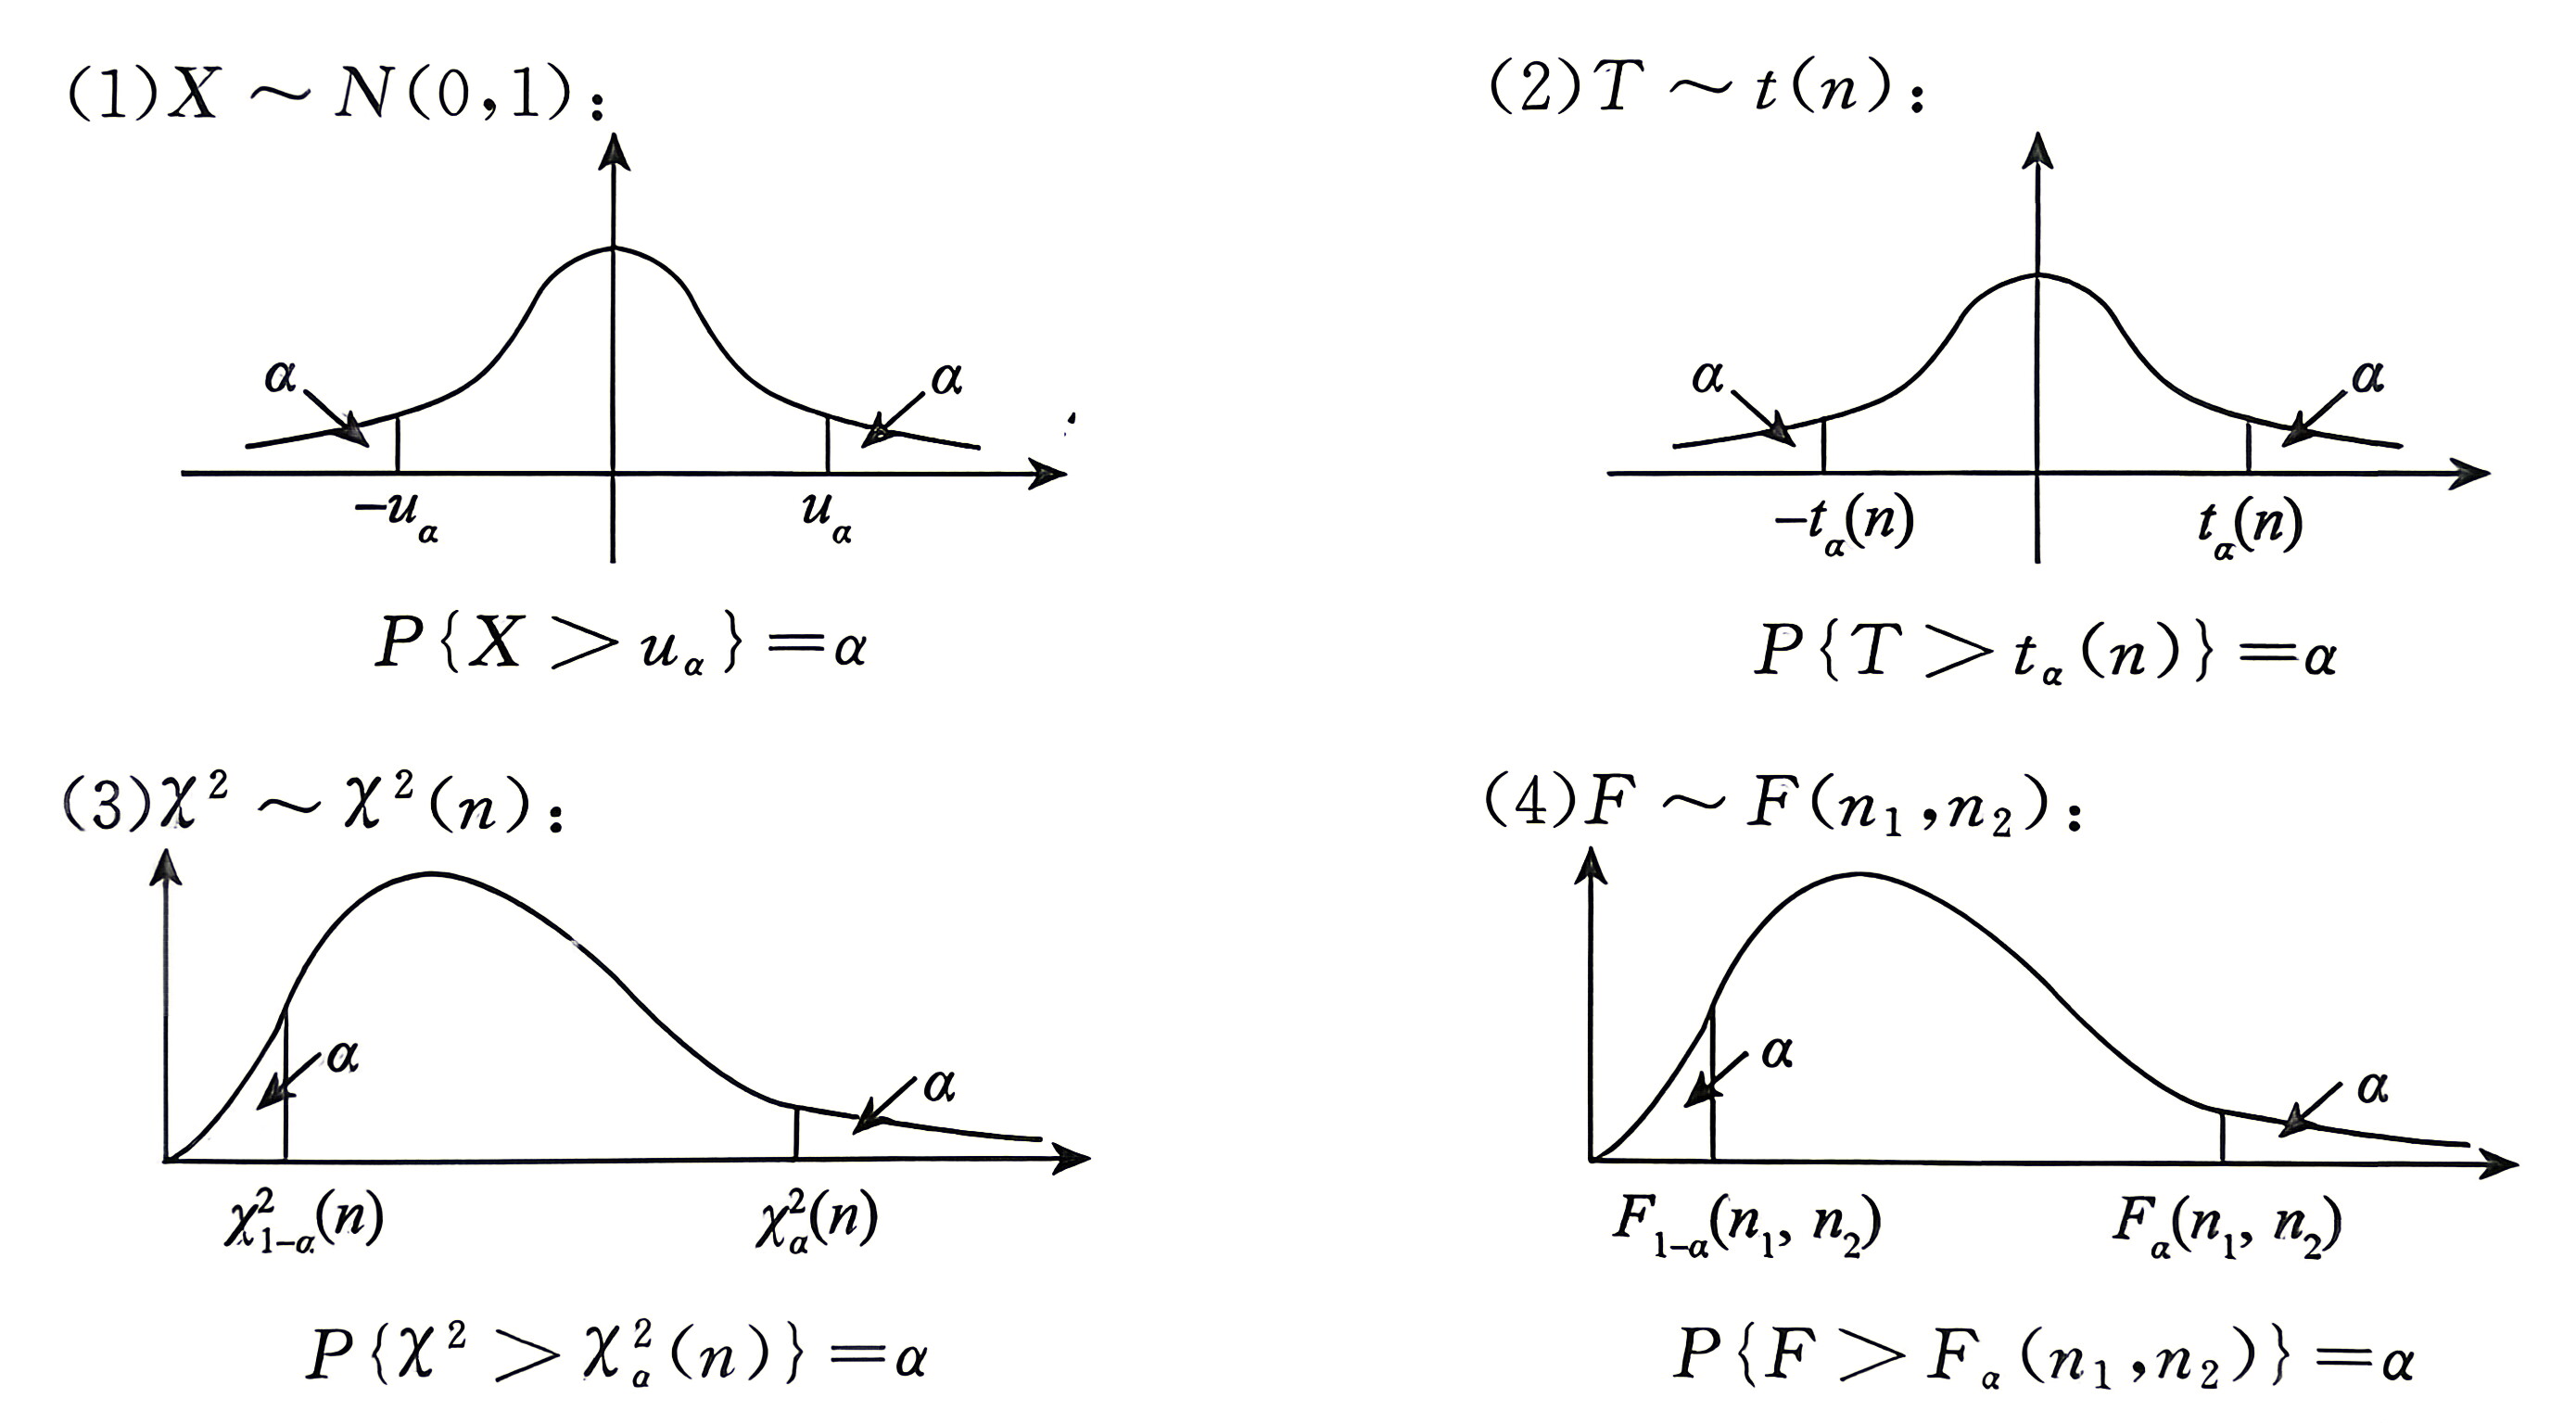
6.6 上侧 alpha 分位点

原本是正态分布里面的那个标准正态分布查表法,这里也可以推广到 χ2\chi^2、tt、FF 分布中

  1. χ2\chi^2 分布的上侧 α\alpha 分位点

    • P{χ2>χα2(n)}=∫χα2(n)+∞f(x)dx=αP\{\chi^2 > \chi^2_{\alpha}(n)\} = \int^{+\infty}_{\chi^2_{\alpha}(n)}f(x)dx = \alpha
  2. tt 分布的上侧 α\alpha 分位点

    • P{T>tα(n)}=∫tα(n)+∞f(x)dx=αP\{T > t_{\alpha}(n)\} = \int^{+\infty}_{t_{\alpha}(n)}f(x)dx = \alpha
  3. FF 分布的上侧 α\alpha 分位点

    • P{F>Fα(n1,n2)}=∫Fα(n1,n2)+∞f(x)dx=αP\{F > F_{\alpha}(n_1, n_2)\} = \int^{+\infty}_{F_{\alpha}(n_1, n_2)}f(x)dx = \alpha

statistics1

💡 上侧分位点,顾名思义,就是从右侧 1 开始的分位点

6.7 单正态总体下常用统计量的分布

设 X~N(μ,σ2)X ~ N(\mu, \sigma^2),(X1,X2,...,Xn)(X_1, X_2, ..., X_n) 为来自总体 XX 的简单随机样本,则

  1. 关于 X‾\overline{X}
    • (1)X‾=1n∑i=1nXi~N(μ,σ2n)\overline{X} = \dfrac{1}{n}\sum\limits_{i=1}^{n} X_i ~ N(\mu, \dfrac{\sigma^2}{n})
    • (2)X‾−μσ2n~N(0,1)\dfrac{\overline{X} - \mu}{\sqrt{\frac{\sigma^2}{n}}}~N(0, 1)
    • (3)X‾\overline{X} 与 S2S^2 相互独立,且有 X‾−μSn~t(n−1)\dfrac{\overline{X} - \mu}{\frac{S}{\sqrt{n}}}~t(n - 1)

💡 关于(3)的证明: X‾−μSn=X‾−μσ/nS2/nσ/n=X‾−μσ/nS2/σ2=X‾−μσ/n1n−1∑i=1n(Xi−X‾σ)2\dfrac{\overline{X} - \mu}{\frac{S}{\sqrt{n}}} = \dfrac{\frac{\overline{X} - \mu}{\sigma / \sqrt{n}}}{\frac{\sqrt{S^2 / n}}{\sigma /\sqrt{n}}} = \dfrac{\frac{\overline{X} - \mu}{\sigma / \sqrt{n}}}{\sqrt{S^2 / \sigma^2}} = \dfrac{\frac{\overline{X} - \mu}{\sigma / \sqrt{n}}}{\sqrt{\frac{1}{n-1} \sum\limits_{i=1}^n (\frac{X_i - \overline{X}}{\sigma})^2}},分子~ N(0,1)N(0, 1),分母~ χ2(n−1)\chi^2(n-1)

  1. 关于 S2S^2
    • (1)X‾\overline{X} 与 S2S^2 相互独立,且 (n−1)S2σ2=∑i=1n(Xi−X‾)2σ2~χ2(n−1)\dfrac{(n-1)S^2}{\sigma^2} = \dfrac{\sum\limits_{i=1}^{n} (X_i - \overline{X})^2}{\sigma^2} ~ \chi^2(n - 1)
    • (2)∑i=1n(Xi−μ)2σ2~χ2(n)\dfrac{\sum\limits_{i=1}^{n} (X_i - \mu)^2}{\sigma^2} ~ \chi^2(n)(提示:Xi−μσ~N(0,1)\dfrac{X_i - \mu}{\sigma} ~ N(0, 1))

⚠️ 东西有点多,容易遗忘,但一定要熟练掌握!

6.8 双正态总体

设 X1,X2,...,Xn1X_1, X_2, ..., X_{n_1} 和 Y1,Y2,...,Yn2Y_1, Y_2, ..., Y_{n_2} 分别为来自正态分布 N(μ1,σ12)N(\mu_1, \sigma_1^2) 和 N(μ2,σ22)N(\mu_2, \sigma_2^2) 的简单随机样本,且两组样本相互独立,令两个样本的均值和方差分别为

  • X‾=1n1∑i=1n1Xi~N(μ1,σ12n1)\overline{X} = \dfrac{1}{n_1}\sum\limits_{i=1}^{n_1}X_i ~ N(\mu_1, \dfrac{\sigma_1^2}{n_1})
  • S12=1n1−1∑i=1n1(Xi−X‾)2S_1^2 = \dfrac{1}{n_1 - 1} \sum\limits_{i=1}^{n_1} (X_i - \overline{X})^2
  • Y‾=1n2∑i=1n2Yi~N(μ2,σ22n2)\overline{Y} = \dfrac{1}{n_2}\sum\limits_{i=1}^{n_2}Y_i ~ N(\mu_2, \dfrac{\sigma_2^2}{n_2})
  • S22=1n2−1∑i=1n2(Yi−Y‾)2S_2^2 = \dfrac{1}{n_2 - 1} \sum\limits_{i=1}^{n_2} (Y_i - \overline{Y})^2

则有

  1. 关于均值

    • X‾±Y‾~N(μ1±μ2,σ12n1+σ22n2)\overline{X} \pm \overline{Y} ~ N(\mu_1 \pm \mu_2, \dfrac{\sigma_1^2}{n_1} + \dfrac{\sigma_2^2}{n_2})
    • (X‾±Y‾)−(μ1±μ2)σ12n1+σ22n2~N(0,1)\dfrac{(\overline{X} \pm \overline{Y}) - (\mu_1 \pm \mu_2) }{\sqrt{\dfrac{\sigma_1^2}{n_1} + \dfrac{\sigma_2^2}{n_2}}}~N(0, 1)
  2. 关于方差

    • (n1−1)S12σ12+(n2−1)S22σ22~χ2(n1+n2−2)\dfrac{(n_1 - 1)S_1^2}{\sigma_1^2} + \dfrac{(n_2 - 1)S_2 ^2}{\sigma_2^2} ~\chi^2 (n_1 + n_2 - 2)
    • 1σ12∑i=1n1(Xi−μ1)2/n11σ22∑i=1n2(Yi−μ2)2/n2=∑i=1n1(Xi−μ1)2/(n1σ12)∑i=1n2(Yi−μ2)2/(n2σ22)~F(n1,n2)\dfrac{\dfrac{1}{\sigma_1^2} \sum\limits_{i=1}^{n_1}(X_i -\mu_1)^2 / n_1}{\dfrac{1}{\sigma_2^2} \sum\limits_{i=1}^{n_2}(Y_i -\mu_2)^2 / n_2} = \dfrac{ \sum\limits_{i=1}^{n_1}(X_i- \mu_1)^2 / (n_1\sigma_1^2)}{ \sum\limits_{i=1}^{n_2}(Y_i -\mu_2)^2 / (n_2 \sigma_2^2)} ~F(n_1, n_2)
    • S12/σ12S22/σ22~F(n1−1,n2−1)\dfrac{S_1^2 / \sigma_1^2}{S_2^2 / \sigma_2^2}~F(n_1-1, n_2 - 1)
  3. 设 σ12=σ22=σ2\sigma_1^2 = \sigma_2^2 = \sigma^2,则有

    • T=(X‾−Y‾)−(μ1−μ2)SW21n1+1n2~t(n1+n2−2)T = \dfrac{(\overline{X} - \overline{Y}) - (\mu_1 - \mu_2)}{S_W^2 \sqrt{\dfrac{1}{n_1} + \dfrac{1}{n_2}}}~t(n_1 + n_2 - 2)
    • SW2=(n1−1)S12+(n2−1)S22n1+n2−2S_W^2 = \dfrac{(n_1-1)S_1^2 + (n_2 - 1)S_2^2}{n_1 + n_2 - 2}

💡 这里可以看看 27 余丙森强化例 6.4

7. 参数估计(重中之重)

7.1 参数的点估计、估计量、估计值

  1. 估计量 θ^(X1,X2,...,Xn)\hat{\theta}(X_1, X_2, ..., X_n) 是一个随机变量
  2. 估计值 θ^(x1,x2,...,xn)\hat{\theta}(x_1, x_2, ..., x_n) 为估计量所取的具体值
  3. 点估计 就是用估计量的值估计位置参数的值

7.2 矩估计法

  1. 用样本矩估计相应的总体矩从而得到参数估计的方法称为矩估计法

  2. 总体矩:

    • μk=E(Xk)\mu_k = E(X^k)
    • γk=E{[X−E(X)]k}\gamma_k = E\{[X - E(X)]^k\}

小结论:

  • μ1=E(X)\mu_1 = E(X)
  • μ2=E(X2)\mu_2 = E(X^2)
  • γ2=D(X)\gamma_2 = D(X)
  1. 样本矩:
    • Ak=1n∑i=1nXikA_k = \dfrac{1}{n} \sum\limits_{i=1}^{n}X_i^k
    • Bk=1n∑i=1n(Xi−X‾)kB_k = \dfrac{1}{n} \sum\limits_{i=1}^{n} (X_i - \overline{X})^k

小结论:

  • A1=X‾A_1 = \overline{X}
  • A2=1n∑i=1nXi2A_2 = \dfrac{1}{n}\sum\limits_{i=1}^{n} X_i^2
  • B2=1n(∑i=1nXi2−nX‾2)B_2 = \dfrac{1}{n}(\sum\limits_{i=1}^{n}X_i^2 - n\overline{X}^2)
  1. 关系:

    • E(Ak)=μkE(A_k) = \mu_k
    • 由大数定律,Ak⟶PμkA_k \overset{P}{\longrightarrow} \mu_k,A1⟶Pμ1A_1 \overset{P}{\longrightarrow} \mu_1、A2⟶Pμ2A_2 \overset{P}{\longrightarrow} \mu_2、Bk⟶PD(X)B_k \overset{P}{\longrightarrow} D(X)
  2. 计算方法:设总体 XX 的分布函数为 F(x;θ1,...,θk)F(x;\theta_1, ..., \theta_k),其中 θi(i=1,2,...,k)\theta_i (i = 1,2,..., k) 为待估参数,X1,X2,...,XnX_1, X_2, ..., X_n 为总体 XX 的一个样本,则求矩估计的步骤为

    • (1)求出总体矩(原点矩或中心矩)E(Xi)E(X^i) 或 E[X−E(X)]iE[X - E(X)]^i
    • (2)令总体矩等于相应的样本矩,得方程组,即
      • 原点矩 1n∑j=1nXji=E(Xi)\dfrac{1}{n} \sum\limits_{j=1}^{n}X_j^i = E(X^i)
      • 或中心矩 1n∑j=1n(Xj−X‾)i=E[X−E(X)]i\dfrac{1}{n} \sum\limits_{j=1}^{n}(X_j - \overline{X})^i = E[X - E(X)]^i
    • (3)解上面的方程组,得 θi\theta_i 的矩估计值为 θ^i(x1,x2,...,xn)\hat{\theta}_i(x_1, x_2, ..., x_n),θi\theta_i 的矩估计量为 θ^i(X1,X2,...,Xn)\hat{\theta}_i(X_1, X_2, ..., X_n)

⚠️ 有 kk 个未知参数就求到 kk 阶原点矩或中心矩,为方便计算,一般取原点矩

7.3 最大似然估计法

  1. 似然函数:样本 X1,X2,...,XnX_1, X_2, ..., X_n 取到观察值 x1,x2,...,xnx_1, x_2, ..., x_n 的概率 L(θ)L(\theta)

    • (1)离散型:XX 分布律为 P{X=xi}=p(xi;θ)P\{X=x_i\} = p(x_i;\theta),则似然函数 L(θ)=P{X1=x1,X2=x2,...,Xn=xn}=∏i=1nP{Xi=xi}=∏i=1np{xi;θ}L(\theta) = P\{X_1 = x_1, X_2=x_2, ..., X_n=x_n\} = \prod\limits^{n}_{i=1} P\{X_i=x_i\} = \prod\limits^{n}_{i=1} p\{x_i; \theta\}
    • (2)连续型:XX 概率密度为 f(x)=f(x;θ)f(x) = f(x; \theta),则似然函数 L(θ)=∏i=1nf(xi;θ)L(\theta) = \prod\limits_{i=1}^{n} f(x_i; \theta)
  2. 思想:在 θ\theta 的取值范围内求 θ^\hat{\theta} 使 L(θ^)=max⁡L(θ)L(\hat{\theta}) = \max L(\theta)

  3. 解题步骤:

    • (1)写出似然函数 L(θ)={∏i=1np{xi;θ}Discrete∏i=1nf(xi;θ)ContinuousL(\theta) = \begin{cases} \prod\limits^{n}_{i=1} p\{x_i; \theta\} & Discrete \\ \prod\limits_{i=1}^{n} f(x_i; \theta) & Continuous \end{cases}
    • (2)求似然函数 L(θ)L(\theta) 的最大值点,若 L(θ)L(\theta) 或 ln⁡L(θ)\ln L(\theta) 可微且易于计算,则可令 dL(θ)dθ=0\dfrac{dL(\theta)}{d\theta} = 0 或 dln⁡L(θ)dθ=0\dfrac{ d \ln L(\theta)}{d\theta} = 0,从而解得 θ\theta(若 XX 的分布中包含多个未知量,即 θ=(θ1,θ2,...,θn)\theta = (\theta_1, \theta_2, ..., \theta_n),则可以分别令偏导数等于 0 解出对应的 θi\theta_i)
    • (3)解出来的 θ\theta 就是最大似然估计值 θ^i(x1,x2,...,xn)\hat{\theta}_i(x_1, x_2, ..., x_n),最大似然估计量为 θ^i(X1,X2,...,Xn)\hat{\theta}_i(X_1, X_2, ..., X_n)

💡 若题目给出“样本观察值为 x1x_1、x2x_2、…、xnx_n”(哪怕只有一个样本 x1x_1),那么

  • 矩估计中样本均值就是这几个样本的平均值
  • 最大似然函数就是把这几个样本观察值代入概率密度函数后相乘
  1. 最大似然估计的不变性:
    • 设 θ^\hat{\theta} 是未知参数 θ\theta 的最大似然估计,对于 θ\theta 的函数 g(θ)g(\theta),如果 g(θ)g(\theta) 具有单值反函数,则 g(θ^)g(\hat{\theta}) 为 g(θ)g(\theta) 的最大似然估计
    • 例题可参考 27 张宇 1000a 数理统计第 15 题

⚠️ 若最大似然估计法求解据估计量 θ^\hat{\theta} 的过程中,求导之后发现函数为单调递增(或单调递减),那么 θ^\hat{\theta} 直接取得边界值,比如边界值为 x≥θ(x≤θ)x\ge \theta (x\le \theta),那么据估计量 θ^\hat{\theta} 等于 min⁡{X1,X2,...,Xn}(max⁡{X1,X2,...,Xn})\min\{X_1, X_2, ..., X_n\} (\max\{X_1, X_2, ..., X_n\})

7.4 估计量的评选标准

  1. 无偏性:
    • 设 θ^\hat{\theta} 为 θ\theta 的估计量,若 E(θ^)=θE(\hat{\theta}) = \theta,则 θ^\hat{\theta} 为 θ\theta 的无偏估计量,否则为有偏估计量
    • 若 lim⁡n→0E(θ^)=θ\lim\limits_{n \to 0} E(\hat{\theta}) = \theta,则称 θ^\hat{\theta} 为 θ\theta 的渐近无偏估计

💡 常用结论:

  • (1)X‾\overline{X} 是 E(X)=μE(X) = \mu 的无偏估计,即 E(X‾)=E(X)=μE(\overline{X}) = E(X) = \mu
  • (2)S2S^2 是 D(X)=σ2D(X) = \sigma^2 的无偏估计,即 E(S2)=D(X)=σ2E(S^2) = D(X) = \sigma^2
  • (3)设 θ1^,θ2^,...,θn^\hat{\theta_1}, \hat{\theta_2}, ..., \hat{\theta_n} 均为 θ\theta 的无偏估计,c1,c2,...,cnc_1, c_2, ..., c_n 为常数且 ∑i=1nci=1\sum\limits_{i=1}^{n}c_i = 1,则 c1θ1^+c2θ2^+...+cnθn^c_1\hat{\theta_1} + c_2\hat{\theta_2} + ... + c_n\hat{\theta_n} 仍是 θ\theta 的无偏估计

💡 最小方差估计量

  • 在无偏估计量的前提下,方差最小的估计量称为最小方差估计量(出现在 27 张宇 1000a 数理统计 17 题)
  1. 有效性:

    • 设 θ1^,θ2^\hat{\theta_1}, \hat{\theta_2} 均为 θ\theta 的无偏估计,若 D(θ1^)<D(θ2^)D(\hat{\theta_1}) < D(\hat{\theta_2}),则称 θ1^\hat{\theta_1} 比 θ2^\hat{\theta_2} 更有效
  2. 一致性(相合性):

    • 若对 ∀ϵ>0\forall \epsilon > 0,有 lim⁡n→∞P{∣θ^−θ∣<ϵ}=1\lim\limits_{n\to \infty} P\{|\hat{\theta} - \theta| < \epsilon\} = 1,则称 θ^\hat{\theta} 为 θ\theta 的一致估计量或相合估计量

💡 看到一致性,有没有想到切比雪夫不等式?

⚠️ 易错点

  • 样本方差 S2S^2 是总体方差 σ2\sigma^2 的无偏估计量
  • 但样本标准差 SS 不是总体标准差 σ\sigma 的无偏估计量!
  • 未修正的样本标准差是总体标准差 σ\sigma 的最大似然估计量
  • 样本标准差 SS 不是总体标准差 σ\sigma 的最大似然估计
  • 样本标准差 SS 是总体标准差 σ\sigma 的相合估计量

7.5 区间估计

  1. 置信区间:P{θ1^<θ<θ2^}≥1−αP\{\hat{\theta_1} < \theta < \hat{\theta_2}\} \ge 1 - \alpha,则称 (θ1^,θ2^)(\hat{\theta_1}, \hat{\theta_2}) 为未知参数 θ\theta 的置信水平(置信度)为 1−α1- \alpha 的置信区间。

  2. 单正态总体下参数 μ,σ2\mu, \sigma^2 的置信区间(设总体 X~N(μ,σ2)X~N(\mu, \sigma^2),求取置信度为 1−α1-\alpha)

题意枢轴量双侧置信区间单侧置信限
σ2\sigma^2 已知,估 μ\muZ=X‾−μσ/n∼N(0,1)Z = \dfrac{\overline{X} - \mu}{\sigma / \sqrt{n}} \sim N\left(0, 1\right)(X‾−σnzα/2,X‾+σnzα/2)\left(\overline{X} - \dfrac{\sigma}{\sqrt{n}}z_{\alpha/2}, \overline{X} + \dfrac{\sigma}{\sqrt{n}}z_{\alpha/2}\right)μ‾=X‾+σnzαμ‾=X‾−σnzα\overline{\mu} = \overline{X} + \dfrac{\sigma}{\sqrt{n}}z_{\green\alpha} \\ \underline{\mu} = \overline{X} - \dfrac{\sigma}{\sqrt{n}}z_{\green\alpha}
σ2\sigma^2 未知,估 μ\muT=X‾−μS/n∼t(n−1)T = \dfrac{\overline{X} - \mu}{S / \sqrt{n}} \sim t\left(\red{n - 1}\right)(X‾−Sntα/2(n−1),X‾+Sntα/2(n−1))\left(\overline{X} - \dfrac{S}{\sqrt{n}}t_{\alpha/2}\left(\red{n - 1}\right), \overline{X} + \dfrac{S}{\sqrt{n}}t_{\alpha/2}\left(\red{n - 1}\right)\right)μ‾=X‾+Sntα(n−1)μ‾=X‾−Sntα(n−1)\overline{\mu} = \overline{X} + \dfrac{S}{\sqrt{n}}t_{\green\alpha}\left(\red{n - 1}\right) \\ \underline{\mu} = \overline{X} - \dfrac{S}{\sqrt{n}}t_{\green\alpha}\left(\red{n - 1}\right)
μ\mu 已知,估 σ2\sigma^2χ2=∑i=1n(Xi−μ)2σ2∼χ2(n)\chi^2 = \dfrac{\sum\limits^n_{i=1}\left(X_i - \mu\right)^2}{\sigma^2} \sim \chi^2\left(n\right)(∑i=1n(Xi−μ)2χα/22(n),∑i=1n(Xi−μ)2χ1−α/22(n))\left(\dfrac{\sum\limits^n_{i=1}\left(X_i - \mu\right)^2}{\chi^2_{\alpha/2}\left(n\right)}, \dfrac{\sum\limits^n_{i=1}\left(X_i - \mu\right)^2}{\chi^2_{1-\alpha/2}\left(n\right)}\right)σ2‾=∑i=1n(Xi−μ)2χ1−α2(n)σ2‾=∑i=1n(Xi−μ)2χα2(n)\overline{\sigma^2} = \dfrac{\sum\limits^n_{i=1}\left(X_i - \mu\right)^2}{\chi^2_{1-\green\alpha}\left(n\right)} \\ \underline{\sigma^2} = \dfrac{\sum\limits^n_{i=1}\left(X_i - \mu\right)^2}{\chi^2_{\green\alpha}\left(n\right)}
μ\mu 未知,估 σ2\sigma^2χ2=(n−1)S2σ2∼χ2(n−1)\chi^2 = \dfrac{\left(n - 1\right) S^2}{\sigma^2} \sim \chi^2\left(n - 1\right)((n−1)S2χα/22(n−1),(n−1)S2χ1−α/22(n−1))\left(\dfrac{\left(n - 1\right) S^2}{\chi^2_{\alpha/2}\left(n - 1\right)}, \dfrac{\left(n - 1\right) S^2}{\chi^2_{1 - \alpha/2}\left(n - 1\right)}\right)σ2‾=(n−1)S2χ1−α2(n−1)σ2‾=(n−1)S2χα2(n−1)\overline{\sigma^2} = \dfrac{\left(n - 1\right) S^2}{\chi^2_{1 - \green\alpha}\left(n - 1\right)} \\ \underline{\sigma^2} = \dfrac{\left(n - 1\right) S^2}{\chi^2_{\green\alpha}\left(n - 1\right)}
  1. 双正态总体均值和方差的置信水平为 1−α1-\alpha 的区间估计
待估参数其他参数双侧置信区间
μ1−μ2\mu_1 - \mu_2σ12,σ22\sigma_1^2,\sigma_2^2 已知(X‾−Y‾−uα/2σ12n1+σ22n2,X‾−Y‾+uα/2σ12n1+σ22n2)\left( \overline{X} - \overline{Y} - u_{\alpha/2}\sqrt{\dfrac{\sigma_1^2}{n_1} + \dfrac{\sigma_2^2}{n_2}}, \overline{X} - \overline{Y} + u_{\alpha/2}\sqrt{\dfrac{\sigma_1^2}{n_1} + \dfrac{\sigma_2^2}{n_2}} \right)
μ1−μ2\mu_1 - \mu_2σ12,σ22\sigma_1^2,\sigma_2^2 未知但 σ12=σ22\sigma_1^2 = \sigma_2^2(X‾−Y‾−tα/2(n1+n2−2)Sw1n1+1n2,X‾−Y‾+tα/2(n1+n2−2)Sw1n1+1n2)\left( \overline{X} - \overline{Y} - t_{\alpha/2}(n_1+n_2-2) S_w \sqrt{\dfrac{1}{n_1} + \dfrac{1}{n_2}}, \overline{X} - \overline{Y} + t_{\alpha/2}(n_1+n_2-2) S_w \sqrt{\dfrac{1}{n_1} + \dfrac{1}{n_2}} \right)
σ12σ22\dfrac{\sigma_1^2}{\sigma_2^2}μ1,μ2\mu_1, \mu_2 已知(1n1∑i=1n(Xi−μ1)/1n2∑i=1n(Yi−μ2)Fα/2(n1,n2),1n1∑i=1n(Xi−μ1)/1n2∑i=1n(Yi−μ2)F1−α/2(n1,n2))\left( \dfrac{\frac{1}{n_1} \sum\limits_{i=1}^{n}(X_i - \mu_1) / \frac{1}{n_2} \sum\limits_{i=1}^{n}(Y_i - \mu_2)}{F_{\alpha/2}(n_1, n_2)}, \dfrac{\frac{1}{n_1} \sum\limits_{i=1}^{n}(X_i - \mu_1) / \frac{1}{n_2} \sum\limits_{i=1}^{n}(Y_i - \mu_2)}{F_{1- \alpha/2}(n_1, n_2)} \right)
σ12σ22\dfrac{\sigma_1^2}{\sigma_2^2}μ1,μ2\mu_1, \mu_2 未知(S12S22⋅1Fα/2(n1−1,n2−1),S12S22⋅1F1−α/2(n1−1,n2−1))\left(\dfrac{S_1^2}{S_2^2} \cdot \dfrac{1}{F_{\alpha/2}(n_1 - 1, n_2 - 1)}, \dfrac{S_1^2}{S_2^2} \cdot \dfrac{1}{F_{1-\alpha/2}(n_1 - 1, n_2 - 1)}\right)
  • 其中 Sw2=(n1−1)S12+(n2−1)S22n1+n2−2S_w^2 = \dfrac{(n_1 - 1)S_1^2 + (n_2 - 1)S_2^2}{n_1 + n_2 -2 }

💡 置信水平的意义:

用同一种抽样方法反复抽样、反复构造置信区间时,其中大约有 1−α1- \alpha 的比例能够包含真实参数

比如:1−α=951 - \alpha = 95%

上面这个置信度的含义是:如果我们反复抽样 100 次,并且每次都按同样的方法算一个置信区间,那么大约有 95 个区间会包含真实参数总体,大约 5 个区间不包含真实参数

那么,置信水平越高,区间通常越宽;置信水平越低,区间通常越窄

8. 假设检验

8.1 假设检验的定义与常用概念

  1. 假设检验的具体做法:

    • (1)根据问题的需要对所研究的总体作某种假设,记作 H0H_0
    • (2)选取合适的统计量,这个统计量的选取要使得在假设 H0H_0 成立时,其分布为已知
    • (3)由实测的样本,计算出统计量的值,并根据预先给定的显著性水平进行检验,作出拒绝或接受假设 H0H_0 的判断
  2. 备择假设:与原假设 H0H_0 相对的假设 H1H_1

  3. 检验统计量:用于假设检验问题的统计量称为检验统计量

  4. 拒绝域与临界点

    • 当检验统计量的观测值落在某一个区域时就拒绝 H0H_0,这一区域称为拒绝域
    • 拒绝域的边界称为临界点
  5. 假设检验的两类错误

    • (1)第一类错误(弃真错误):原假设 H0H_0 为真时,但检验结果为拒绝原假设 H0H_0
    • (2)第二类错误(取伪错误):原假设 H0H_0 不真时,但检验结果为接受原假设 H0H_0
  6. 犯两类错误的概率

    • (1)第一类错误:α=P{\alpha = P\{拒绝H0∣H0H_0|H_0为真}\}
    • (2)第二类错误:α=P{\alpha = P\{接受H0∣H0H_0|H_0为假}\}

⚠️ 易错点:假设题目告诉你原假设 H0H_0、备择假设 H1H_1,拒绝域 W={X‾>3}W = \{\overline{X} > 3\},那么

  • (1)计算犯第一类错误的概率,即在 H0H_0 成立的前提下,落入拒绝域 WW 的概率
  • (2)计算犯第二类错误的概率,即在 H1H_1 成立的前提下,落在拒绝域 WW 外面(即 X‾≤3\overline{X} \le 3)的概率
  • 典型例题:【1000a.30.23】、【1000a.30.24】

8.2 显著性检验

  1. 显著性检验的定义

    • (1)显著性水平:在假设检验中允许犯第一类错误的概率记为 α(0<α<1)\alpha(0<\alpha<1),则 α\alpha 称为显著性水平,它体现了对弃真错误的控制程度
    • (2)显著性检验:只控制第一类错误概率 α\alpha 的统计检验,称为显著性检验
  2. 显著性检验的一般步骤(大题套路)

    • (1)根据实际问题提出原假设 H0H_0
    • (2)如果为单侧检验(≥\ge 或 ≤\le),那么可以将原假设 H0H_0 或备择假设 H1H_1 转化到边界处(例如原假设 H0:μ≥10H_0:\mu \ge 10 可以转化为 H0:μ=10H_0: \mu = 10)
    • (3)选择合适的检验统计量 TT 并写出拒绝域 WW 的形式
    • (3)给出显著性水平 α(0<α<1)\alpha(0<\alpha<1),并依据第一类错误的概率等于 α\alpha 求出拒绝域
    • (4)根据题目所给样本值计算检验统计量 TT 的观测值,当观测值落在拒绝域内则拒绝原假设 H0H_0,否则接受原假设 H0H_0

⚠️ 题目如果说要检验什么,那么原假设 H0H_0 就应该设为要检验的命题的逆命题

  1. 显著性水平为 α\alpha 的单正态总体均值和方差的假设检验
H0↔H1H_0 \leftrightarrow H_1H0H_0 为真时检验统计量及其分布H0H_0 的拒绝域 WW
μ=μ0↔μ≠μ0\mu = \mu_0 \leftrightarrow \mu \ne \mu_0(σ2\sigma^2 已知) \\ U=X‾−μ0σ/n~N(0,1)U = \dfrac{\overline{X} - \mu_0}{\sigma / \sqrt{n}} ~N(0, 1)∣U∣≥uα2\begin{vmatrix} U \end{vmatrix} \ge u_{\frac{\alpha}{2}}
μ≤μ0↔μ>μ0\mu \le \mu_0 \leftrightarrow \mu > \mu_0同上U≥uαU\ge u_{\alpha}
μ≥μ0↔μ<μ0\mu \ge \mu_0 \leftrightarrow \mu < \mu_0同上U≤−uαU \le -u_{\alpha}
μ=μ0↔μ≠μ0\mu = \mu_0 \leftrightarrow \mu \ne \mu_0(σ2\sigma^2 未知) \\ T=X‾−μ0S/n~t(n−1)T = \dfrac{\overline{X} - \mu_0}{S / \sqrt{n}} ~t(n-1)∣T∣≥tα2(n−1)\begin{vmatrix} T \end{vmatrix} \ge t_{\frac{\alpha}{2}}(n-1)
μ≤μ0↔μ>μ0\mu \le \mu_0 \leftrightarrow \mu > \mu_0同上T≥tα(n−1)T\ge t_{\alpha}(n-1)
μ≥μ0↔μ<μ0\mu \ge \mu_0 \leftrightarrow \mu < \mu_0同上T≤−tα(n−1)T\le -t_{\alpha}(n-1)
σ2=σ02↔σ2≠σ02\sigma^2 = \sigma_0^2 \leftrightarrow \sigma^2 \ne \sigma_0^2(μ\mu 已知)\\ χ2=∑i=1n(Xi−μ)2σ02~χ2(n)\chi^2 = \dfrac{\sum\limits_{i=1}^{n}(X_i - \mu)^2}{\sigma_0^2} ~\chi^2(n)χ2≥χα22(n)\chi^2 \ge \chi^2_{\frac{\alpha}{2}}(n) 或 χ2≤χ1−α22(n)\chi^2 \le \chi^2_{1-\frac{\alpha}{2}}(n)
σ2≤σ02↔σ2>σ02\sigma^2 \le \sigma_0^2 \leftrightarrow \sigma^2 > \sigma_0^2同上χ2≥χα2(n)\chi^2 \ge \chi^2_{\alpha}(n)
σ2≥σ02↔σ2<σ02\sigma^2 \ge \sigma_0^2 \leftrightarrow \sigma^2 < \sigma_0^2同上χ2≤χ1−α2(n)\chi^2 \le \chi^2_{1-\alpha}(n)
σ2=σ02↔σ2≠σ02\sigma^2 = \sigma_0^2 \leftrightarrow \sigma^2 \ne \sigma_0^2(μ\mu 未知)\\ χ2=(n−1)S2σ02~χ2(n−1)\chi^2 = \dfrac{(n-1)S^2}{\sigma_0^2}~\chi^2(n-1)χ2≥χα22(n−1)\chi^2 \ge \chi^2_{\frac{\alpha}{2}}(n-1) 或 χ2≤χ1−α22(n−1)\chi^2 \le \chi^2_{1-\frac{\alpha}{2}}(n-1)
σ2≤σ02↔σ2>σ02\sigma^2 \le \sigma_0^2 \leftrightarrow \sigma^2 > \sigma_0^2同上χ2≥χα2(n−1)\chi^2 \ge \chi^2_{\alpha}(n-1)
σ2≥σ02↔σ2<σ02\sigma^2 \ge \sigma_0^2 \leftrightarrow \sigma^2 < \sigma_0^2同上χ2≤χ1−α2(n−1)\chi^2 \le \chi^2_{1-\alpha}(n-1)

🐱 有没有感觉拒绝域就是上面 7.5 置信区间取反喵?

  1. 双正态总体
H0↔H1H_0 \leftrightarrow H_1H0H_0 为真时检验统计量及其分布H0H_0 的拒绝域 WW
μ1=μ2↔μ1≠μ2\mu_1 = \mu_2 \leftrightarrow \mu_1 \ne \mu_2(σ12,σ22\sigma_1^2, \sigma_2^2 均未知,但 σ12=σ22\sigma_1^2 = \sigma_2^2) \\ T=X‾−Y‾S/1n1+1n2~t(n1+n2−2)T = \dfrac{\overline{X} - \overline{Y}}{S / \sqrt{\frac{1}{n_1} + \frac{1}{n_2}}} ~t(n_1 + n_2 -2)∣T∣≥tα2(n1+n2−2)\begin{vmatrix} T \end{vmatrix} \ge t_{\frac{\alpha}{2}}(n_1 + n_2 -2)
μ1≤μ2↔μ1>μ2\mu_1 \le \mu_2 \leftrightarrow \mu_1 > \mu_2同上T≥tα(n1+n2−2)T\ge t_{\alpha}(n_1 + n_2 -2)
μ1≥μ2↔μ1<μ2\mu_1 \ge \mu_2 \leftrightarrow \mu_1 < \mu_2同上T≤−tα(n1+n2−2)T\le -t_{\alpha}(n_1 + n_2 -2)
σ12=σ22↔σ12≠σ22\sigma_1^2 = \sigma_2^2 \leftrightarrow \sigma_1^2 \ne \sigma_2^2(μ1,μ2\mu_1, \mu_2 未知)\\ F=S12S22~F(n1−1,n2−1)F = \dfrac{S_1^2}{S_2^2}~F(n_1-1, n_2-1)F≥Fα2(n1−1,n2−1)F \ge F_{\frac{\alpha}{2}}(n_1-1, n_2-1) 或 F≤F1−α2(n1−1,n2−1)F \le F_{1-\frac{\alpha}{2}}(n_1-1, n_2-1)
σ12≤σ22↔σ12>σ22\sigma_1^2 \le \sigma_2^2 \leftrightarrow \sigma_1^2 > \sigma_2^2同上F≥Fα(n1−1,n2−1)F \ge F_{\alpha}(n_1-1, n_2-1)
σ12≥σ22↔σ12<σ22\sigma_1^2 \ge \sigma_2^2 \leftrightarrow \sigma_1^2 < \sigma_2^2同上F≤F1−α(n1−1,n2−1)F \le F_{1-\alpha}(n_1-1, n_2-1)
  1. 显著性水平的意义:原假设 H0H_0 成立,经检验 H0H_0 被拒绝的概率(可以理解为犯错的概率)【1000a.30.22】

💡 来看个典型例题
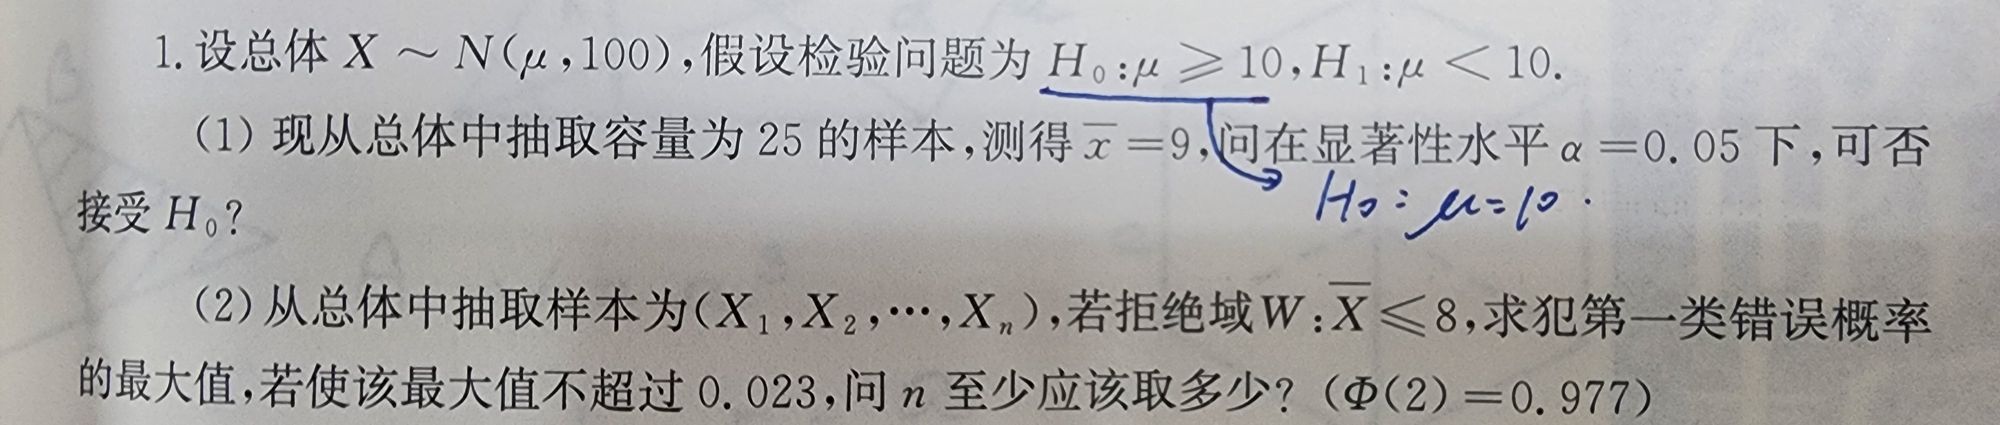
problem81

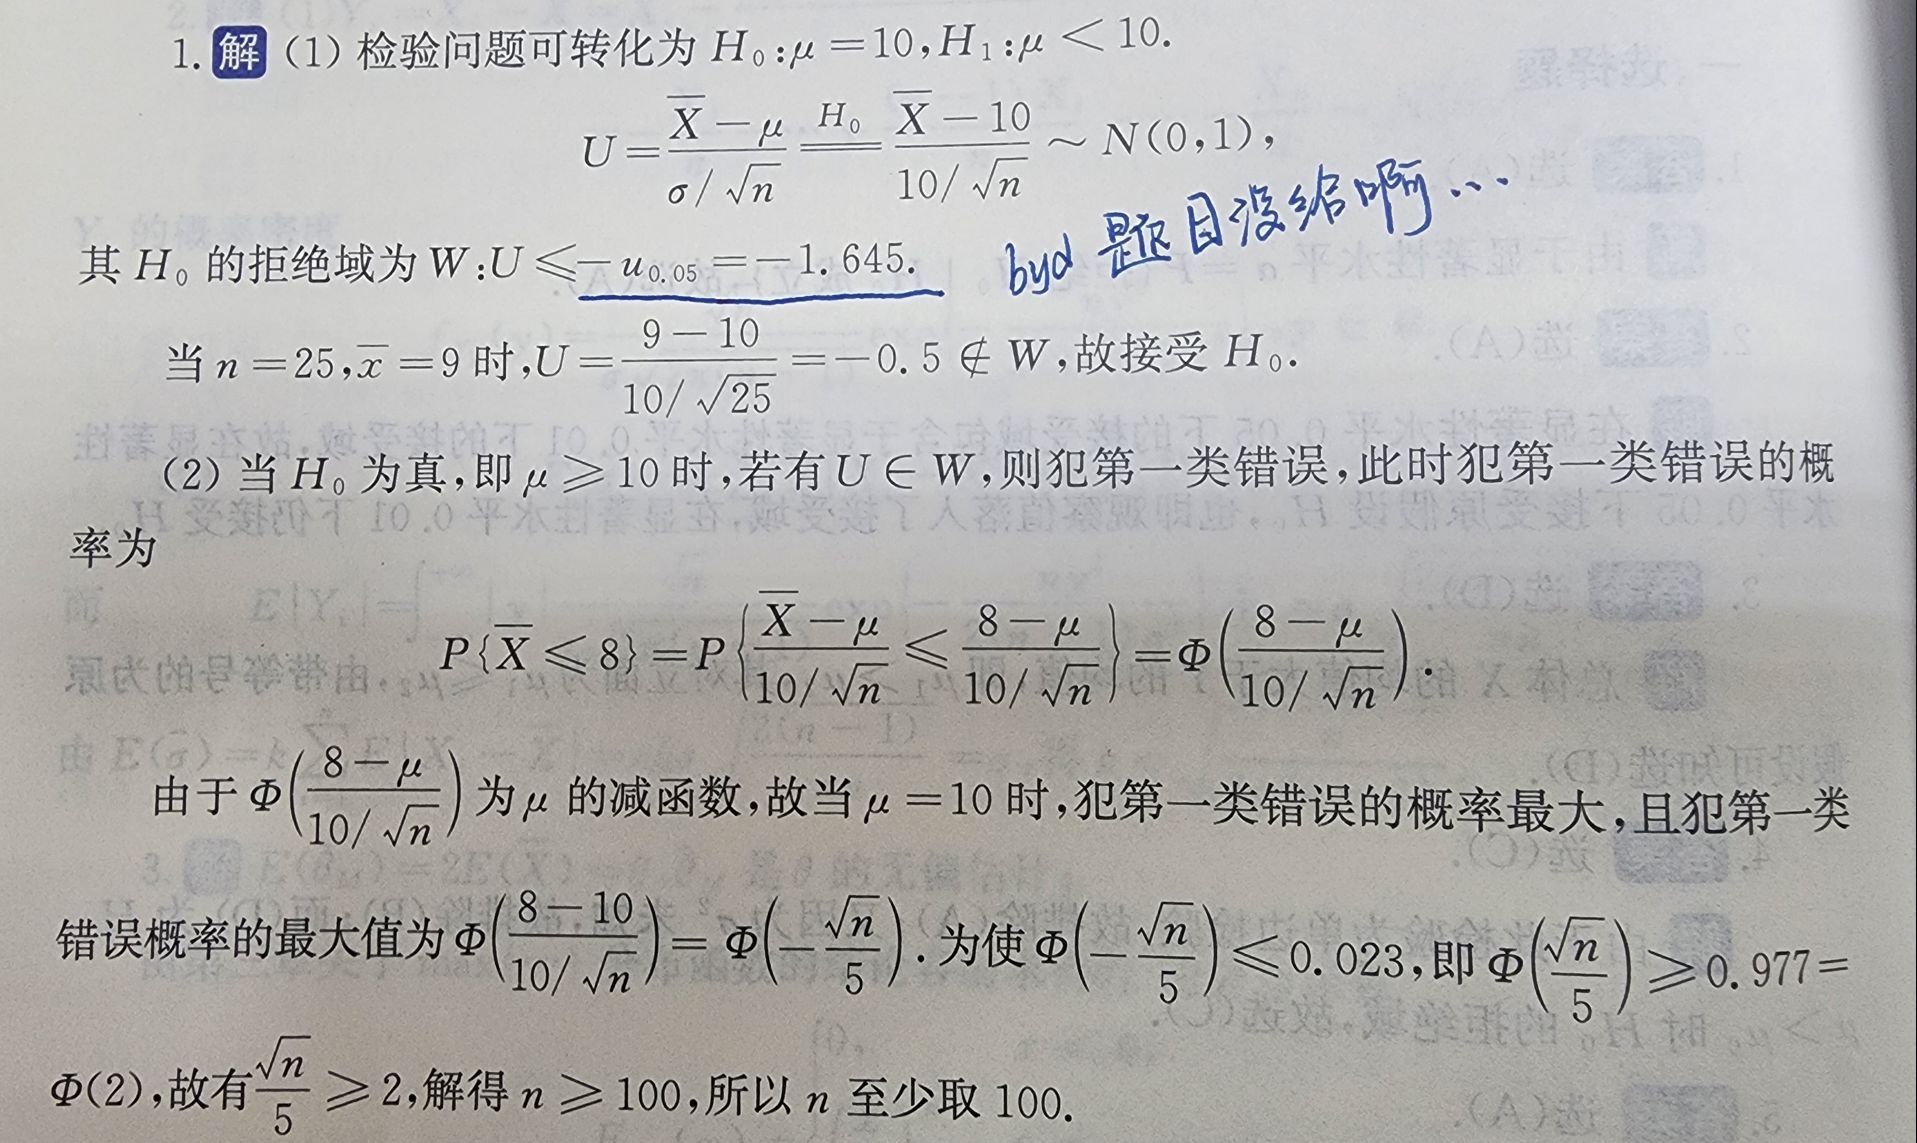
answer81

参考文献

[1] 《2026 方浩概率论基础课程讲义》,方浩

[2] 《考研数学概率论与数理统计辅导讲义》2027 版,余丙森,国家开放大学出版社

[3] 《张宇考研数学基础 30 讲》